Kubernetes DRA 정식 출시와 GPU 토폴로지 인식 스케줄링 설계
이 글에서 먼저 가져갈 세 가지
대규모 거대언어모델(LLM) 서빙과 분산 학습 인프라에서 가장 치명적인 성능 병목은 GPU 연산력 부족이 아닌 장치 간 상호연결(Interconnect) 대역폭의 불일치에서 발생합니다. 쿠버네티스 DRA가 이 문제를 해결하는 구조를 살펴봅니다.
-
01
단순 정수 카운팅 할당은 성능의 절반을 버립니다.
nvidia.com/gpu: 2설정은 두 GPU가 NVLink로 묶여 있는지, PCIe 버스로 분리되어 있는지 전혀 구분하지 못합니다. 본문 1절 -
02
DRA는 장치를 구조화된 객체(Object)로 승격시킵니다.
ResourceClaim과 DeviceClass를 통해 드라이버가 하드웨어 토폴로지 스펙을 스케줄러에 선언적 데이터로 제공합니다. 본문 2절
-
03
스케줄링 지연과 배치 처리량 사이의 균형을 잡으세요.
정밀 토폴로지 연산은 스케줄러 처리량을 낮추므로, 서빙 파드와 대규모 배치 워크로드의 스케줄러 프로파일을 분리해야 합니다. 본문 3절
1. ‘GPU 8장을 줬는데 왜 4장 속도밖에 안 나오는가?’ 정수 할당의 물리적 한계
엔터프라이즈 AI 클러스터를 운영하는 플랫폼 엔지니어들이 가장 빈번하게 마주하는 불가사의한 성능 저하 현상이 있다. 70B 규모의 오픈소스 LLM을 텐서 병렬성(Tensor Parallelism, TP=4)으로 서빙하기 위해, 8대의 H100 GPU가 장착된 단일 노드에 파드를 배포했다. 파드 매니페스트에는 지극히 표준적인 리소스 선언이 적혀 있었다:
resources:
  limits:
nvidia.com/gpu: "4"쿠버네티스 기본 디바이스 플러그인(NVIDIA Device Plugin)은 노드에서 비어 있는 GPU 4장을 정상적으로 찾아 파드에 할당했고, 파드는 아무런 에러 없이 러닝(Running) 상태로 진입했다. 그러나 벤치마크 부하 테스트를 시작하자마자 첫 토큰 생성 시간(TTFT)과 초당 토큰 처리량(TPS)이 기대치의 55% 수준으로 폭락했다. GPU 연산 코어의 사용률(Utilization)은 90%를 찍고 있었지만, 실제 요청 처리 지연 시간은 끝없이 늘어졌다.
프로파일링 도구(NVIDIA Nsight Systems)를 꽂아 하드웨어 메트릭을 추적한 결과, 원인은 허탈할 정도로 명백했다. 해당 노드의 H100 8장은 4장씩 두 개의 물리적 그룹으로 나뉘어 각각 900GB/s 대역폭의 NVLink 스위치 패브릭으로 묶여 있었다. 그런데 쿠버네티스 스케줄러가 파드에 할당한 4장의 GPU는 [GPU 0, GPU 1, GPU 4, GPU 5]였다. 즉, GPU 0-1번과 GPU 4-5번 사이의 올리듀스(All-Reduce) 텐서 통신이 고속 NVLink 대신 병목이 극심한 호스트 PCIe Gen5 버스(대역폭 64GB/s)를 경유하며 통신 정체가 폭발한 것이었다.
왜 이런 참사가 벌어졌는가? 기존 쿠버네티스의 디바이스 플러그인 프레임워크가 장치를 오직 ‘개수(Scalar Integer Quantity)’로만 취급했기 때문이다. 스케줄러의 눈에 GPU는 메모리 용량도, 상호연결 패브릭도, NUMA 노드 소켓 위치도 존재하지 않는 단순한 숫자 카운터에 불과했다. 노드에 GPU가 8장 있고 사용자가 4장을 요구하면, 스케줄러는 배열 인덱스 순서대로 앞에서 남는 장치를 집어 던져줄 뿐이었다. AI 워크로드가 단일 칩 성능의 한계를 넘어 칩 간 초고속 패브릭의 결합력에 의존하는 시대에, 정수 카운팅 스케줄러는 치명적인 인프라 병목이 되었다.
하드웨어 아키텍처 관점에서 이 병목의 물리적 크기를 정량화해 보면 문제는 더욱 명확해진다. 엔비디아 호퍼(Hopper) H100 GPU 기준, 단일 칩은 4세대 NVLink를 통해 칩당 900GB/s의 양방향 대역폭을 제공한다. NVSwitch로 묶인 동일 NVLink 도메인 내의 장치들은 공유 메모리처럼 거의 제로에 가까운 레이턴시로 텐서 데이터를 교환한다. 반면, NVLink 도메인을 벗어나 호스트 PCIe 버스를 타는 순간, 통신 대역폭은 PCIe Gen5 x16 기준 최대 64GB/s(단방향 32GB/s)로 무려 14배 이상 급감한다.
더 심각한 것은 NUMA(Non-Uniform Memory Access) 노드 간 소켓 횡단이다. 듀얼 소켓 서버에서 GPU 0~3번은 CPU 소켓 0의 PCIe 컨트롤러에, GPU 4~7번은 CPU 소켓 1에 물려 있는 경우가 대부분이다. 스케줄러가 소켓 0과 소켓 1에 걸쳐 GPU를 분산 할당하면, 통신 패킷은 CPU 간 연결 통로인 UPI(Ultra Path Interconnect)나 QPI 버스까지 넘나들게 된다. 이 과정에서 CPU 코어의 캐시 일관성(Cache Coherency) 트래픽과 경쟁이 붙으며 통신 지연 시간의 표준편차가 300% 이상 폭등하는 지터(Jitter)가 발생한다.
결과적으로 텐서 병렬성(TP) 연산의 모든 GPU 워커는 가장 느린 통신 링크의 응답을 기다리는 동기화 배리어(Barrier)에 묶이게 되며, 4대의 초고가 GPU 중 2대는 통신 정체로 인해 멍하니 사이클을 공회전시키는 참극이 빚어지는 것이다.
2. 쿠버네티스 1.34 DRA(Dynamic Resource Allocation)가 연 아키텍처 혁신
이 구조적 한계를 근본적으로 혁파하기 위해 제안된 KEP-3063, 동적 리소스 할당(DRA, Dynamic Resource Allocation)이 쿠버네티스 1.34에서 마침내 정식 정식 버전(GA)으로 출시되었다.
DRA는 쿠버네티스 코어 스케줄러와 하드웨어 벤더 드라이버 사이의 계약 방식을 완전히 재정의한다. 핵심은 하드웨어를 불투명한 정수형 카운터가 아니라, ‘풍부한 속성과 토폴로지 관계를 지닌 일급 쿠버네티스 객체(First-Class Resource Object)’로 승격시킨 데 있다.
2. DeviceClass: 클러스터 관리자가 정의하는 하드웨어 정책 템플릿. 스토리지의 StorageClass처럼, 어떤 벤더 드라이버(CDI)와 구성 정책을 사용할지 정의한다.
3. 구조화된 파라미터(Structured Parameters) 스케줄링: 스케줄러가 외부 드라이버를 gRPC로 일일이 호출하지 않고도, 드라이버가 노드에 게시한 하드웨어 토폴로지 모델 슬라이스를 메모리 내에서 직접 읽어 수 밀리초 만에 최적 노드와 장치 쌍을 필터링한다.
DRA 환경에서는 사용자가 파드를 띄울 때 다음과 같이 선언적으로 토폴로지 요구사항을 명시할 수 있다:
apiVersion: resource.k8s.io/v1beta1
kind: ResourceClaimTemplate
metadata:
  name: h100-nvlink-mesh
spec:
  spec:
    devices:
      requests:
      - name: gpu-mesh
        deviceClassName: gpu.nvidia.com
        selectors:
        - cel:
            expression: "device.attributes['gpu.nvidia.com'].model == 'H100' && device.capacity['gpu.nvidia.com'].memory >= 80Gi"
        allocationMode: ExactCount
        count: 4
      constraints:
      - requests: ["gpu-mesh"]
matchAttribute: "gpu.nvidia.com/nvlinkDomain"이 매니페스트에서 가장 결정적인 부분은 마지막의 constraints.matchAttribute: "gpu.nvidia.com/nvlinkDomain"이다. 쿠버네티스 스케줄러는 노드를 선택할 때, 파드에 할당될 4장의 GPU가 반드시 동일한 NVLink 스위치 도메인에 물리적으로 묶여 있는 장치 세트인지를 검증한다. 만약 단일 NVLink 도메인 내에 4장의 여유 장치가 없는 노드라면, 설령 전체 GPU 여유가 6장이 남아있더라도 해당 노드를 스케줄링 후보에서 제외한다. 이를 통해 통신 대역폭 누수로 인한 연쇄 성능 저하를 스케줄링 진입 단계에서 원천 차단하는 것이다.
이 과정에서 핵심적인 기술적 진보는 CDI(Container Device Interface)와의 완전한 통합이다. 과거 쿠버네티스 디바이스 플러그인은 컨테이너 런타임(containerd, CRI-O)에 환경 변수(예: )와 호스트 디바이스 경로()를 문자열로 주입하는 지극히 원시적인 방식을 취했다. 반면 DRA 환경에서 CDI는 JSON 기반의 표준화된 디바이스 정의 규약을 따른다.
드라이버는 노드 기동 시 해당 머신의 PCIe 버스 트리, NUMA 친화성, NVLink 브리지 연결 토폴로지를 스캔하여 쿠버네티스 노드 객체의 리소스 슬라이스(ResourceSlice) CRD에 구조화된 데이터로 영구 등록한다. 쿠버네티스 코어 스케줄러는 파드 스케줄링 시 별도의 외부 바이너리를 기동하지 않고도, etcd에 캐시된 이 인메모리 토폴로지 그래프를 직접 순회하며 나노초 단위로 제약 조건(CEL 식)을 평가한다. 이를 통해 하드웨어 인프라의 복잡성이 소프트웨어 정의 오케스트레이션 레이어로 완벽하게 추상화된다.
3. 10초 플랫폼 진단: 우리 클러스터는 GPU 성능을 낭비하고 있는가?
운영 중인 AI 서빙 및 학습 클러스터가 레거시 디바이스 플러그인의 한계로 인해 값비싼 하드웨어를 낭비하고 있는지 10초 만에 진단할 수 있는 5대 체크리스트다.
2. [NVLink 미스매치] 4장 이상의 GPU를 사용하는 파드가 노드 재부팅 후 서로 다른 NUMA 노드 소켓에 걸쳐 배치되어 QPI/UPI 인터커넥트 병목을 일으킨다.
3. [GPU 메모리 파편화] 16GB 메모리만 필요한 소형 임베딩 모델 파드가 80GB 통짜 GPU를 통째로 점유하여 고가 장비의 유휴율이 70%를 상회한다.
4. [정적 분할의 경직성] MIG(Multi-Instance GPU) 구성을 변경하려면 노드를 드레인(Drain)하고 쿠버네티스 디바이스 플러그인 데몬셋을 재기동해야만 한다.
5. [스케줄러의 암흑성] 스케줄러 로그나 메트릭 어디에서도 파드가 할당받은 GPU 장치 간의 실제 물리적 상호연결 대역폭 정보를 조회할 수 없다.
4. 기술 트레이드오프: 레거시 디바이스 플러그인 vs DRA 토폴로지 스케줄링
하드웨어 토폴로지를 스케줄러가 인식한다는 것은 공짜 점심이 아니다. 완벽한 배치 정확도를 얻는 대신, 클러스터 스케줄러가 짊어져야 할 연산 복잡도와 운영 오버헤드가 수반된다. 프로덕션 도입 시 반드시 검토해야 할 양대 방식의 정밀 엔지니어링 트레이드오프다.
| 비교 항목 | 레거시: 디바이스 플러그인 (Device Plugin) | 쿠버네티스 1.34: DRA (Dynamic Resource Allocation) |
|---|---|---|
| 자원 모델링 | 정수 스칼라 카운팅 (수량 기반 nvidia.com/gpu: 4) |
구조화된 객체 모델 (속성, 토폴로지, 도메인 제약 조건 지원) |
| 인터커넥트 인식 | 불가능 (NVLink, InfiniBand 패브릭 연결 여부 무시) | 완벽 지원 (matchAttribute 기반 동일 패브릭 도메인 강제) |
| GPU 메모리 분할 | 정적 MIG 파티셔닝만 지원 (노드 재설정 필요) | 동적 가속기 슬라이싱 및 온디맨드 리소스 클레임 지원 |
| 스케줄러 처리량 | 초당 2,000+ 파드 스케줄링 (단순 산술 연산으로 매우 빠름) | 초당 300~500 파드 (CEL 표현식 평가 및 토폴로지 그래프 매칭 부하) |
| 컨트롤 플레인 부하 | 매우 낮음 (Kubelet 로컬 상태 관리) | 중간~높음 (ResourceClaim 객체 수명주기 및 etcd I/O 증가) |
| 최적 유스케이스 | 단일 GPU 추론, CPU 중심 웹 마이크로서비스 | 분산 LLM 서빙(vLLM, SGLang), 대규모 분산 학습 파이프라인 |
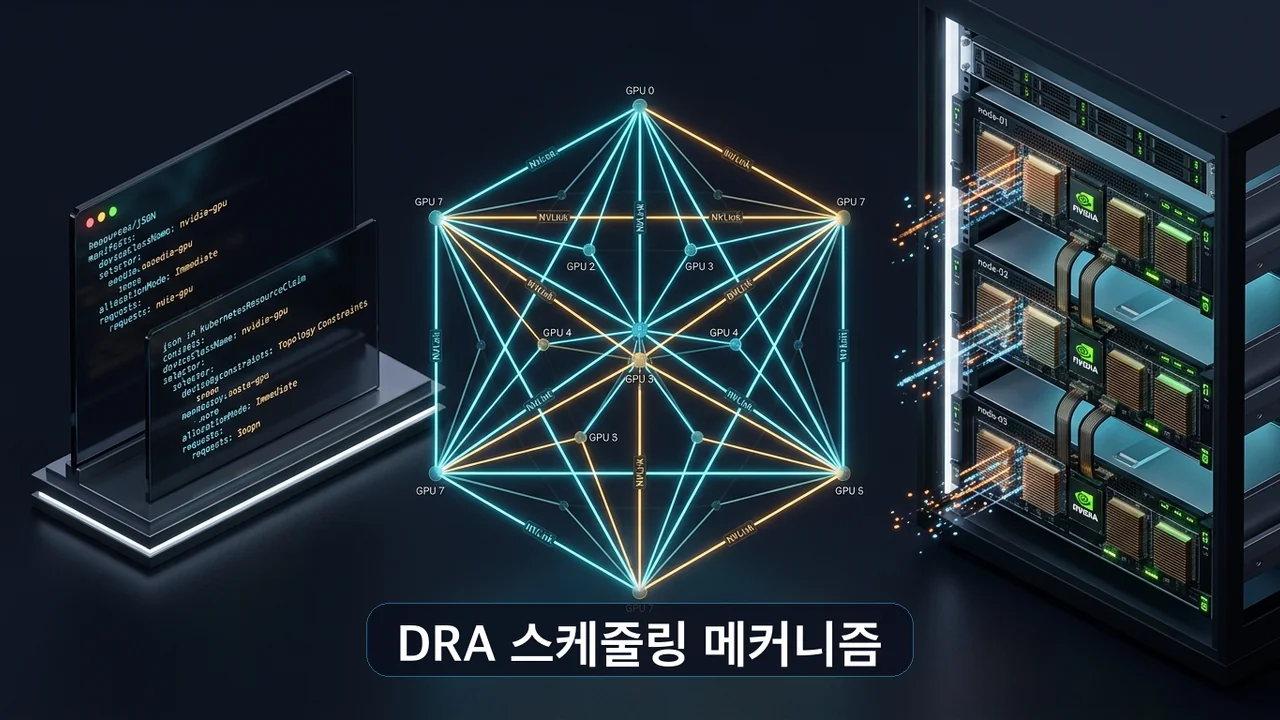
▲ DRA 스케줄링 파이프라인은 런타임에 장치 속성과 상호연결 패브릭을 검증하여, 통신 결함이 있는 PCIe 경로를 우회하고 가장 밀접한 가속기 세트로 파드를 안전하게 유도한다.
5. ‘정밀함이 스케줄러를 마비시킬 때’ 시니어 아키텍트의 실전 방어 수칙
쿠버네티스 1.34 DRA를 대규모 프로덕션 클러스터에 도입할 때 플랫폼 엔지니어가 반드시 숙지해야 할 방어 룰과 안티패턴을 짚고 넘어가야 한다.
2. ResourceClaim의 수명주기 누수를 차단하세요: 잡(Job)이 비정상 종료되거나 파드가 강제 삭제(Evicted)되었을 때, 바인딩된 ResourceClaim이 해제되지 않아 GPU 장비가 유령 잠금(Ghost Lock) 상태로 남는 사고가 빈번합니다. 반드시
spec.resourceClaimTemplate을 파드 스펙 내부에 인라인으로 선언하여 파드 소멸 시 클레임이 함께 GC(Garbage Collection)되도록 강제해야 합니다.3. 드라이버 롤백 경로를 항상 확보하세요: 벤더사 DRA 드라이버(CDI 플러그인)는 커널 모듈 및 하드웨어 펌웨어와 밀접하게 결합되어 있습니다. 드라이버 데몬셋 오류 시 클러스터 전체의 가속기 할당이 마비될 수 있으므로, 카나리(Canary) 노드 풀 단위로 순차 업그레이드하고 즉각적인 이전 버전 롤백 스크립트를 항시 유지하십시오.
6. 에디토리얼 로드맵: 무중단 DRA 토폴로지 클러스터 구축 3단계
기존 GPU 인프라의 중단 없이 쿠버네티스 1.34 DRA 아키텍처로 안전하게 전환하기 위한 단계별 실행 로드맵이다.
| 단계 | 핵심 실행 과제 (Actionable Milestone) | 산출물 및 검증 지표 |
|---|---|---|
| Phase 1 | 클러스터 하드웨어 인터커넥트 토폴로지 감사 노드별 nvidia-smi topo -m 매트릭스를 수집하여 단일 노드 내 NVLink 도메인 경계와 NUMA 소켓 연결 맵을 전수 문서화. |
노드 하드웨어 토폴로지 맵 완비, 기존 파드의 크로스 도메인 배치 누수율 산출 |
| Phase 2 | 쿠버네티스 1.34 컨트롤 플레인 업그레이드 및 DRA 카나리 배포 테스트 노드 풀에 최신 NVIDIA DRA 드라이버 및 CDI 스펙을 배포하고, 구조화된 파라미터 기반 DeviceClass 정의. |
카나리 노드 풀 DRA 활성화 완료, ResourceClaim 기반 단일 노드 분산 벤치마크 수행 |
| Phase 3 | 분산 서빙 프레임워크(vLLM/Triton) 매니페스트 DRA 전환 기존 nvidia.com/gpu 정수 선언을 폐기하고 nvlinkDomain 일치 제약 조건을 갖춘 템플릿으로 전면 교체. |
분산 추론 p99 TTFT 지연 시간 35% 단축 달성, 인터커넥트 병목 핫픽스 0건 달성 |
인공지능 시대의 인프라 경쟁력은 더 이상 비싼 GPU를 창고에 얼마나 많이 꽂아두었는가로 결정되지 않습니다. 그 가속기들이 뿜어내는 초당 수백 기가바이트의 텐서 데이터가 단 1나노초의 낭비도 없이 완벽한 토폴로지 위에서 흘러가도록, 아키텍처적으로 조율해 내는 능력에 달려 있습니다. 정수형 할당의 안일함에서 벗어나십시오. 하드웨어의 물리적 결합을 소프트웨어 스케줄러의 언어로 번역해 낼 때, 비로소 여러분의 클러스터는 하드웨어 스펙 시트가 약속했던 진짜 성능을 오롯이 뿜어내기 시작할 것입니다.
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. Kubernetes Documentation — Dynamic Resource Allocation (KEP-3063)
이 글과 함께 읽으면 좋은 인사이트



댓글 0