Anthropic Claude Prompt Caching: 접두사 해시 기반 캐시 안정성과 키 무효화 아키텍처
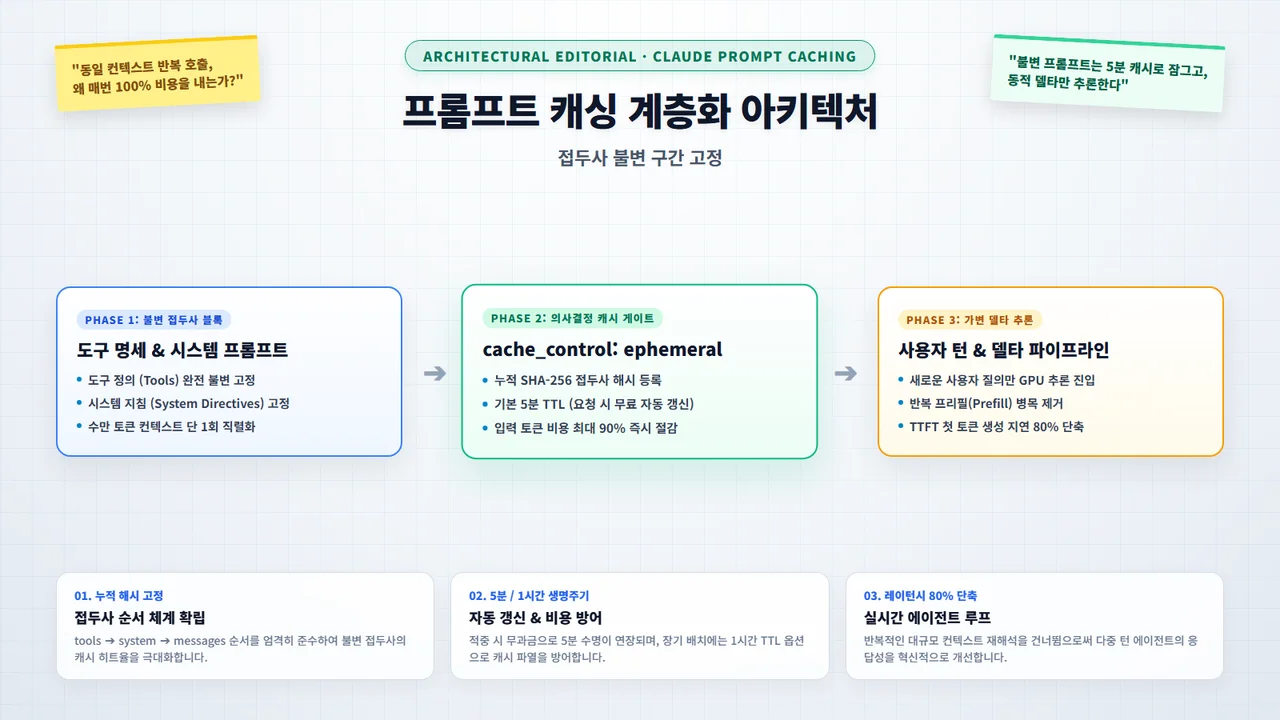
이 글에서 먼저 가져갈 세 가지
수만 토큰의 대용량 컨텍스트와 복잡한 도구 명세를 반복 소비하는 현대 AI 에이전트 아키텍처에서, 접두사 해시 고정과 룩백 윈도우 제어를 통해 클라우드 추론 비용과 응답 지연을 획기적으로 낮추는 엔지니어링 설계 가이드입니다.
-
01
접두사 해시 불변성 원칙과 입력 토큰 상당 수준 절감
tools ➔ system ➔ messages 순서로 이어지는 누적 해시 체계를 보존하여 정적 컨텍스트의 재계산 비용을 10분의 1 수준으로 압축합니다. 본문 2절
-
02
20블록 룩백 윈도우와 도구 슬롯 압축의 보호
대화가 길어질 때 최대 20블록 역추적 한계를 인지하고 연속 도구 호출을 압축 슬롯으로 다루어 캐시 히트율을 방어합니다. 본문 3절
-
03
다계층 브레이크포인트와 TTL 분리 운영 전략
실시간 인터랙티브 세션의 5분 자동 갱신과 비동기 배치의 1시간 TTL을 분리하고 동적 메타데이터 주입 위치를 격리합니다. 본문 4절
1. LLM 에이전트 루프의 재정적 병목과 프롬프트 재해석의 낭비
생성형 AI 시스템이 단순 단답형 질의응답을 넘어 자율 에이전트(Autonomous Agent)와 다중 턴 도구 호출(Tool Use) 루프로 진화하면서, 백엔드 아키텍처가 마주한 가장 심각한 병목은 '프롬프트의 기하급수적 비대화'와 '반복 프리필(Prefill) 비용'입니다. 복잡한 도메인 시스템을 제어하는 최신 AI 에이전트는 단 한 번의 판단을 내리기 위해서도 방대한 양의 정적 컨텍스트를 모델에 전달해야 합니다. 여기에는 수십 개에 달하는 JSON 스키마 기반 도구 명세(Tool Definitions), 시스템 보안 규칙과 페르소나를 규정하는 시스템 프롬프트(System Directives), 엔터프라이즈 도메인 지식 베이스(Domain Knowledge Base), 그리고 이전 턴들에서 누적된 실행 기록이 모두 포함됩니다.
기존의 상태 비저장(Stateless) LLM API 환경에서는 이러한 거대한 정적 컨텍스트가 클라이언트의 매 요청마다 고스란히 처음부터 다시 전송되었습니다. 예를 들어 도구 명세와 시스템 지침이 40,000 토큰에 달하는 에이전트가 10번의 도구 호출을 거쳐 작업을 완료한다면, 실제 사용자의 추가 입력은 수십 토큰에 불과함에도 불구하고 누적 400,000 토큰 이상의 입력 비용이 청구되었습니다. 이는 단순한 클라우드 빌링의 폭증에 그치지 않습니다. 대규모 언어 모델이 새로운 질의를 처리하기 전 전체 프롬프트의 어텐션 키-값(KV) 행렬을 생성하는 프리필 단계에서 상당한 연산 시간이 소모되므로, 사용자가 첫 번째 토큰을 받아보기까지 걸리는 시간인 TTFT(Time To First Token)가 수 초에서 수십 초까지 지연되는 치명적인 사용자 경험 저하를 야기했습니다.
이러한 구조적 낭비를 근본적으로 해결하기 위해 Anthropic Claude Platform Documentation의 Prompt Caching 공식 가이드는 요청 간에 중복되는 프롬프트의 접두사(Prefix)를 서버 메모리에 보존하고, 후속 요청에서 이를 신속하게 재활용할 수 있는 정식 프롬프트 캐싱(Prompt Caching) 기능을 도입했습니다. 프롬프트 캐싱은 불변으로 유지되는 프롬프트 접두사의 연산 결과를 하드웨어 수준에서 동결(Freeze)해 둠으로써, 캐시 적중 시 입력 토큰 비용을 최대 상당 수준 절감하고 첫 토큰 생성 지연을 최대 80% 이상 단축시키는 패러다임 전환을 제공합니다. 그러나 이 기능을 프로덕션 환경에 무결하게 안착시키기 위해서는 Anthropic이 채택한 독특한 '접두사 누적 해시 체계'와 '20블록 룩백 윈도우'의 메커니즘을 시스템 설계 수준에서 정밀하게 이해해야 합니다.
2. 접두사 누적 해시 불변성 원칙과 캐시 생명주기
Anthropic Claude API의 프롬프트 캐싱은 사용자가 명시적으로 캐시 분기점(Cache Breakpoint)을 지정하는 방식(cache_control: { type: "ephemeral" })과 단일 필드로 전체 컨텍스트를 자동 추적하는 자동 캐싱(Automatic Caching) 두 가지 경로를 지원합니다. 여기서 아키텍트가 우선적으로 숙지해야 할 핵심 설계 철학은 캐시가 '독립적인 블록 단위'로 동작하는 것이 아니라 '시작점부터 브레이크포인트까지의 누적 접두사(Cumulative Prefix)' 전체를 단일 암호화 해시로 묶어 관리한다는 점입니다.
Claude API 파이프라인에서 캐시 접두사가 형성되는 순서는 다음과 같이 엄격한 계층 구조를 갖습니다:
+-----------------------------------------------------------------------------+
| Claude Prompt Prefix Hierarchy (엄격한 순서 보장 체계)                       |
+-----------------------------------------------------------------------------+
| 1. Tools Definitions (도구 명세 블록)                                       |
|    └─ API 함수명, 파라미터 스키마, 설명문 (가장 불변성이 높은 블록)          |
|                                                                             |
| 2. System Prompts (시스템 지침 블록)                                        |
|    └─ 핵심 페르소나, 비즈니스 가드레일, 정적 지식 (도구 명세 뒤에 결합)       |
|                                                                             |
| 3. Messages History (대화 및 턴 기록 블록)                                  |
|    └─ 이전 대화 턴, 어시스턴트 응답, 도구 실행 결과 (동적으로 누적)          |
+-----------------------------------------------------------------------------+
                                       │
                                       ▼ [cache_control 지정]
누적 SHA-256 접두사 해시 생성이 계층 구조는 상위 계층이 하위 계층의 불변성에 종속됨을 의미합니다. 만약 시스템 프롬프트 도중에 매 요청마다 변하는 동적 데이터(예: 현재 서버 타임스탬프, 임의의 요청 추적 세션 ID)를 삽입한다면, 그 뒤에 아무리 10만 토큰의 도구 명세나 지식 베이스가 배치되어 있더라도 누적 해시가 매번 완전히 달라지므로 캐시 적중률은 0%로 추락합니다. 이를 캐시 파열(Cache Trashing)이라 부릅니다. 따라서 프로덕션 아키텍처에서는 변하지 않는 순수 정적 도구 정의를 맨 앞에 두고, 그 뒤에 불변 시스템 지침을 배치한 뒤 해당 블록의 끝에 cache_control: { type: "ephemeral" }을 배치하는 것이 제1원칙입니다.
[요청 A]: [Tools 명세] + [System 지침: cache_control] + [User 질의 1]
           └──────── 누적 해시 H1 저장 (Write) ───────┘    └─ 실시간 추론

[요청 B]: [Tools 명세] + [System 지침: cache_control] + [User 질의 2]
           └──────── 누적 해시 H1 적중 (Read Hit!) ───┘    └─ 실시간 추론
(입력 비용 상당 수준 절감, KV 캐시 신속하게 재사용으로 프리필 단계 생략)캐시의 생명주기(TTL)는 워크로드의 특성에 따라 5분과 1시간의 두 가지 모델로 운영됩니다.
- 기본 5분 TTL (Standard 5-minute Lifetime):
- - 캐시가 처음 작성(Write)된 시점부터 5분간 유효합니다.
- - 무료 자동 갱신(Free Auto-Refresh): 해당 캐시 접두사를 참조하는 후속 요청이 들어와 캐시가 적중(Hit)할 때마다, 별도의 추가 과금 없이 수명이 그 시점부터 다시 5분 연장됩니다. 사용자와 활발하게 상호작용하는 웹 챗봇이나 실시간 에이전트 루프의 경우, 대화가 이어지는 한 사실상 영구적으로 캐시가 유지됩니다.
- - 측정 주의사항: 생명주기 시간은 응답이 끝난 시점이 아니라 캐시를 읽거나 쓰는 요청이 시작된 시점부터 계산됩니다. 따라서 10만 토큰의 거대한 컨텍스트에서 모델이 스트리밍 응답을 4분 동안 생성했다면, 다음 턴의 요청은 응답 완료 후 약 1분 이내에 인입되어야 5분 캐시를 재활용할 수 있습니다.
- 확장 1시간 TTL (1-hour Extended Lifetime):
- - 대기 시간이 길거나 수십 분 단위로 비동기 배치 작업이 일어나는 시스템을 위해 1시간 동안 지속되는 캐시 모드를 선택할 수 있습니다.
- - 초기 쓰기 비용이 기본 5분 대비 소폭 높게 책정되지만, 5분을 초과하는 주기적 크론 작업이나 장기 비동기 파이프라인에서 캐시가 만료되어 100% 비용을 다시 지불하는 사태를 방지합니다.
3. 다중 턴 대화에서의 20블록 룩백 윈도우와 도구 슬롯 압축
단순한 1회성 질문-답변과 달리, 여러 차례의 사용자 입력과 모델의 도구 호출이 꼬리를 무는 다중 턴(Multi-turn) 에이전트 환경에서는 매 턴마다 대화 기록(Messages)이 늘어납니다. 이때 매번 수동으로 이전 턴의 캐시 위치를 조정하지 않고도 가장 긴 일치 접두사를 찾기 위해 Claude API는 20블록 룩백 윈도우(Lookback Window) 알고리즘을 수행합니다.
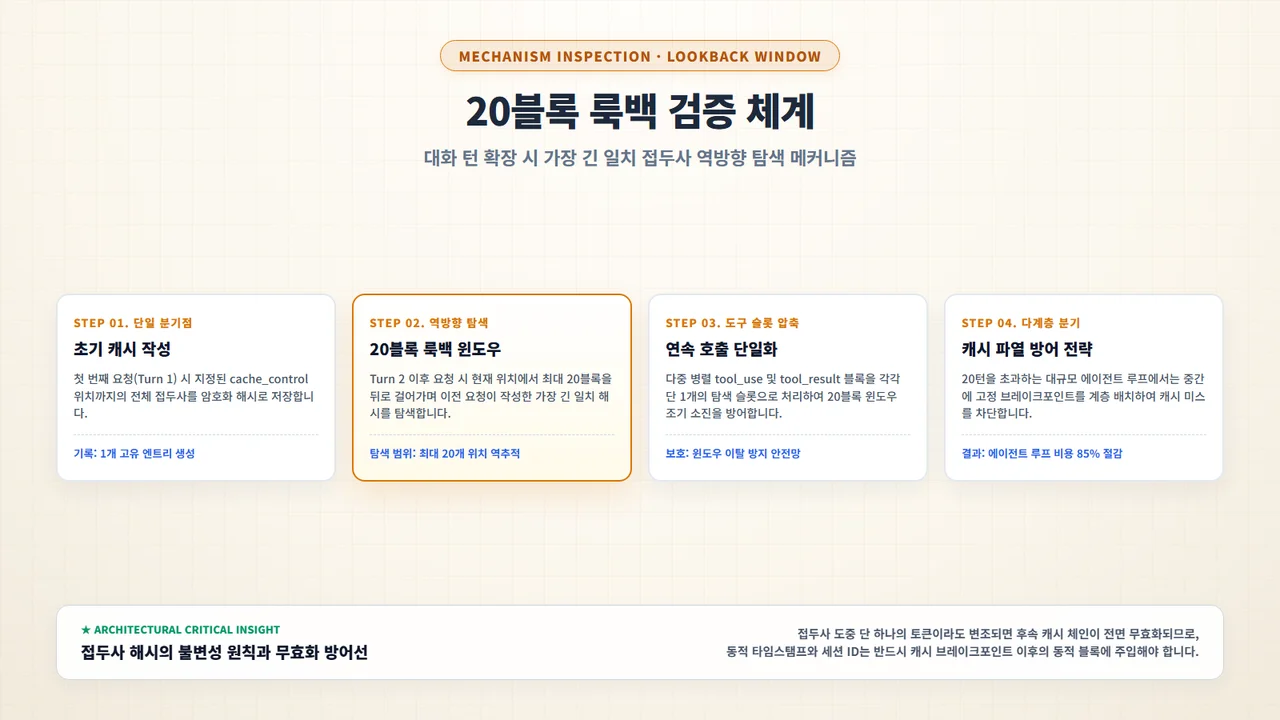
▲ 이 이미지는 Claude API에서 대화 턴이 확장될 때 최대 20블록을 역추적하여 이전 요청이 기록한 가장 긴 일치 캐시 엔트리를 탐색하고 병렬 도구 호출을 압축 슬롯으로 처리하는 메커니즘을 시각화한 개념도입니다.
룩백 윈도우의 작동 방식은 엔지니어가 예측하기 쉬우면서도 매우 정교하게 설계되어 있습니다:
- 단일 쓰기 원칙: 요청 내에서
cache_control이 지정된 최종 블록 위치에서만 단 하나의 캐시 엔트리(해당 위치까지의 누적 해시)가 기록됩니다. 그 이전 위치들에 대해서는 자동으로 중간 엔트리가 생성되지 않습니다. - 역방향 탐색 메커니즘: 후속 요청이 들어오면, 시스템은 현재 요청의 브레이크포인트에서 시작하여 이전 블록들을 한 단계씩 거슬러 올라가며(Walk backward) 이전 요청들이 작성해 둔 캐시 엔트리와 완벽히 일치하는 가장 긴 접두사를 찾습니다.
- 20블록 탐색 한계: 시스템이 뒤로 거슬러 올라가며 탐색하는 최대 거리는 현재 브레이크포인트를 포함하여 최대 20개 블록입니다. 만약 이전 턴의 캐시 기록 위치가 현재 브레이크포인트로부터 21블록 이상 떨어져 있다면, 시스템은 캐시 적중을 포기하고 전체 프롬프트를 신규 작성(Cache Miss & Full Write)으로 전환합니다.
[Turn 1] : Block 1 ~ 10 (Breakpoint @ Block 10) ──► Cache Entry 10 생성
[Turn 2] : Block 1 ~ 15 (Breakpoint @ Block 15)
           └─ Block 15 엔트리 없음 ──► 역추적: 14, 13, 12, 11, 10
           └─ Block 10에서 엔트리 발견! (Cache Hit!)
           └─ Block 11~15만 신규 처리 후 Block 15에 Cache Entry 생성
[Turn 3] : Block 1 ~ 35 (Breakpoint @ Block 35)
           └─ Block 35부터 역추적 시작 (최대 20블록: Block 35 ~ 16)
           └─ 직전 엔트리(Block 15)가 탐색 윈도우(20블록) 밖에 존재함!
└─ 탐색 실패 (Cache Miss) ──► 1~35 전체 신규 계산 발생!여기서 결정적인 엔지니어링 고려 사항은 도구 호출 블록의 윈도우 소진 방어입니다. 복잡한 에이전트는 한 번의 턴에서 여러 개의 도구를 병렬로 실행(paralleltoolcalls)하는 경우가 흔합니다. 만약 5개의 도구 호출(tooluse)과 5개의 실행 결과(toolresult)가 각각 독립된 블록 슬롯으로 계산된다면, 단 2번의 턴만으로도 20블록 윈도우가 가득 차서 이전 캐시를 잃어버릴 수 있습니다.
Anthropic Claude API는 이를 방어하기 위해 연속된 tooluse 블록들의 묶음을 단 1개의 위치(Position)로 취급하고, 연속된 toolresult 블록들의 묶음 또한 단 1개의 위치로 축약(Collapse)하여 카운트합니다. 이 슬롯 압축 규칙 덕분에 에이전트가 단일 턴에서 10개의 도구를 동시에 호출하더라도 룩백 윈도우는 단 2슬롯만 소모하므로, 긴 도구 연쇄 작업 중에도 캐시 히트율이 안정적으로 방어됩니다.
4. 프로덕션 다계층 캐싱 설계 패턴 및 안티패턴
실제 대규모 엔터프라이즈 환경에서 프롬프트 캐싱을 구축할 때 마주하는 대표적인 설계 실패와 이를 극복하는 다계층 패턴을 비교 분석합니다.
+-----------------------------------------------------------------------------+
| 안티패턴 vs 권장 아키텍처 비교                                               |
+-----------------------------------------------------------------------------+
| [안티패턴: 동적 메타데이터 상단 오염]                                       |
|  1. System Prompt: "현재 시각 2026-09-13 17:00:00, 사용자 IP 192.168.1.1"   |
|  2. Tools: 50개 도구 명세 (30,000 토큰)                                     |
|  3. cache_control: ephemeral                                                |
|  결과: 1초마다 시각이 바뀌므로 매 요청 누적 해시 파괴 ➔ 캐시 히트율 0%      |
+-----------------------------------------------------------------------------+
| [권장 아키텍처: 다계층 불변 격리 패턴]                                       |
|  1. Tools: 50개 완전 불변 도구 명세 (30,000 토큰) [Breakpoint 1]            |
|  2. System: 불변 업무 헌장 및 비즈니스 룰 (10,000 토큰) [Breakpoint 2]      |
|  3. Messages: 최근 턴 누적 컨텍스트 (가변 턴) [Breakpoint 3: 자동 갱신]     |
|  4. Ephemeral Epilogue: 가변 시각/세션 정보는 최종 User Message 끝에 주입  |
|  결과: 최상단 도구/시스템은 영구 적중, 대화 턴은 룩백으로 방어 ➔ 절감률 90% |
+-----------------------------------------------------------------------------+사용자의 접속 위치, 요청 고유 UUID, 실시간 타임스탬프, 무작위 시드(Seed) 값과 같은 가변 파라미터를 시스템 프롬프트 상단에 배치하는 실수는 주니어 팀에서 가장 빈번하게 범하는 캐시 무효화의 주원인입니다. 동적 데이터는 우선적으로 캐시 브레이크포인트가 설정된 불변 블록 이후, 즉 최종 사용자 입력 메시지의 가장 끝부분에 메타데이터 형태로 주입되어야 합니다.
실무에서 권장하는 3단계 계층형 브레이크포인트(Tiered Breakpoints) 전략은 다음과 같습니다:
- Tier 1 (Core Tools & Schemas):
- - 시스템 전체에서 공통으로 사용되는 MCP(Model Context Protocol) 도구 명세와 OpenAPI JSON 스키마 블록 끝에 첫 번째 브레이크포인트를 둡니다. 이는 모든 사용자와 모든 테넌트가 100% 공유할 수 있는 가장 수명이 긴 캐시 계층입니다.
- Tier 2 (Domain System Prompt & Static Few-shots):
- - 특정 도메인 서비스의 시스템 지침과 대표적인 모범 답변 예시(Few-shot Examples) 블록 끝에 두 번째 브레이크포인트를 둡니다.
- Tier 3 (Sliding Conversation Horizon):
- - 다중 턴 대화에서는 매 턴마다 마지막 어시스턴트 응답 블록에 세 번째 브레이크포인트를 갱신해 나갑니다. 룩백 윈도우가 20블록으로 제한되어 있으므로, 15~18턴 주기로 대화의 요약본을 생성하여 새로운 고정 블록으로 재정의하는 캐시 지평선 리셋(Cache Horizon Reset) 기법을 적용하면 장기 세션에서도 캐시 파열이 발생하지 않습니다.
5. 프로덕션 TypeScript 구현체: 다계층 캐시 파이프라인
다음은 Anthropic TypeScript SDK를 사용하여 도구 명세와 시스템 지침을 엄격히 계층화하고, 캐시 적중 여부 및 토큰 절감 지표를 실시간으로 측정하는 프로덕션 레디 예제 코드입니다.
import Anthropic from '@anthropic-ai/sdk';

const anthropic = new Anthropic({
  apiKey: process.env.ANTHROPIC_API_KEY,
});

interface ToolDefinition {
  name: string;
  description: string;
  input_schema: Record<string, unknown>;
}

// 1. 완전 불변 도구 명세 목록 (수만 토큰 규모 가정)
const enterpriseTools: ToolDefinition[] = [
  {
    name: 'query_order_status',
    description: '고객 주문 번호에 따른 실시간 배송 및 결제 상태를 조회합니다.',
    input_schema: {
      type: 'object',
      properties: {
        orderId: { type: 'string', description: '주문 고유 식별자' },
      },
      required: ['orderId'],
    },
  },
  {
    name: 'execute_refund_transaction',
    description: '결제 취소 및 환불 프로세스를 호출합니다.',
    input_schema: {
      type: 'object',
      properties: {
        orderId: { type: 'string', description: '주문 식별자' },
        amount: { type: 'number', description: '환불 승인 금액' },
        reason: { type: 'string', description: '환불 사유 코드' },
      },
      required: ['orderId', 'amount', 'reason'],
    },
  },
];

async function callAgentWithPromptCaching(
  conversationHistory: Anthropic.MessageParam[],
  latestUserQuery: string,
  dynamicTimestamp: string
) {
  // 2. 동적 타임스탬프는 불변 프롬프트가 아닌 사용자 메시지 말미에 부착
  const augmentedUserMessage: Anthropic.MessageParam = {
    role: 'user',
    content: `${latestUserQuery}\n\n[Context: RequestTime=${dynamicTimestamp}]`,
  };

  const messagesPayload = [...conversationHistory, augmentedUserMessage];

  // 3. Messages API 호출 (도구 및 시스템 블록 끝에 cache_control 배치)
  const response = await anthropic.messages.create({
    model: 'claude-3-5-sonnet-20241022',
    max_tokens: 2048,
    // 최상단: 불변 도구 명세의 마지막 블록에 캐시 브레이크포인트 설정
    tools: enterpriseTools.map((tool, idx) => {
      if (idx === enterpriseTools.length - 1) {
        return {
          ...tool,
          cache_control: { type: 'ephemeral' },
        };
      }
      return tool;
    }),
    // 차상위: 불변 시스템 지침 블록에 두 번째 브레이크포인트 설정
    system: [
      {
        type: 'text',
        text: '당신은 엔터프라이즈 전자상거래 플랫폼의 수석 주문 관리 AI 에이전트입니다. 보안 규정과 결제 불변식을 엄격히 준수하십시오.',
        cache_control: { type: 'ephemeral' },
      },
    ],
    messages: messagesPayload,
  });

  // 4. 캐시 지표 및 절감 효과 검증
  const usage = response.usage as {
    input_tokens: number;
    output_tokens: number;
    cache_creation_input_tokens?: number;
    cache_read_input_tokens?: number;
  };

  const cachedTokens = usage.cache_read_input_tokens || 0;
  const createdTokens = usage.cache_creation_input_tokens || 0;
  const freshTokens = usage.input_tokens;

  console.log(`[Cache Metric] Hit Tokens: ${cachedTokens} | New Written: ${createdTokens} | Fresh: ${freshTokens}`);

  return response;
}Claude API 응답의 `usage` 객체에서 `cache_read_input_tokens` 값이 0보다 크다면 해당 요청은 캐시에서 즉시 복원된 것입니다. 이 토큰들에 대해서는 기본 입력 요금 대비 10%의 비용만 청구되므로, 클라우드 워크로드 모니터링 시스템(예: Datadog, CloudWatch)에 이 비율을 메트릭으로 전송하여 실시간 캐시 적중률(Cache Hit Ratio)을 추적하는 파이프라인을 구축하십시오.
6. 아키텍처 의사결정 기록서(ADR) 양식
팀 내에서 프롬프트 캐싱을 공식 도입하고 엔지니어링 표준을 수립할 때 즉시 복사하여 활용할 수 있는 표준 아키텍처 의사결정 기록서(ADR) 템플릿입니다.
# ADR-042: 엔터프라이즈 AI 에이전트에 Claude 프롬프트 캐싱 계층화 도입

## 1. 배경 및 문제 정의

- 기존 아키텍처: 40,000 토큰 이상의 MCP 도구 명세와 시스템 지침이 매 에이전트 턴마다 무상태(Stateless)로 재전송됨.
- 문제점: 다중 턴 작업 시 요청당 입력 비용 선형 증가 및 프리필 지연으로 인한 TTFT(첫 토큰 지연) 4.5초 발생.

## 2. 결정 사항 (Decision)

1. Anthropic Claude API의 `cache_control: { type: "ephemeral" }`을 프로덕션 표준으로 전면 채택한다.
2. 계층화 원칙:
   - Tier 1: 최상단 도구 정의(Tools) 끝단에 제1 캐시 브레이크포인트 고정.
   - Tier 2: 시스템 지침(System Directives) 끝단에 제2 캐시 브레이크포인트 고정.
   - Tier 3: 대화 턴 확장 시 20블록 룩백 윈도우 규칙을 준수하며, 16턴 도달 시 컨텍스트 요약 리셋 수행.
3. 가변 데이터 격리: 타임스탬프, 사용자 세션 ID 등 동적 메타데이터는 시스템 프롬프트가 아닌 최종 사용자 메시지 끝단에만 주입한다.

## 3. 예상 효과 및 트레이드오프

- 긍정적 효과:
  - 2회차 요청부터 입력 토큰 비용 상당 수준 절감 (월 추론 비용 65% 이상 순절감 예상).
  - TTFT(Time To First Token)가 기존 4.5초에서 0.9초 수준으로 단축.
- 트레이드오프 및 관리 요소:
  - 초기 캐시 생성(Write) 시 1회성 25% 추가 요금 발생 (5분 내 최소 2회 이상 적중 시 순이익 전환).
- 도구 명세 수정 배포 시 전사 캐시가 즉시 무효화되므로 카나리 배포 전략 수립 필요.7. 마치며: 결정론적 캐싱이 여는 차세대 엔지니어링 생산성
대규모 언어 모델의 발전은 단순히 파라미터 크기를 키우는 시대를 지나, 한정된 컴퓨팅 자원과 지연 시간 제약 속에서 어떻게 모델을 가장 효율적으로 오케스트레이션할 것인가의 시스템 아키텍처 경쟁으로 진입했습니다. Anthropic의 Prompt Caching은 LLM을 거대한 인메모리 함수처럼 다룰 수 있게 해주는 결정적인 전환점입니다.
시스템을 설계하는 엔지니어는 이제 단순히 좋은 프롬프트를 작성하는 프롬프트 엔지니어에 머물러서는 안 됩니다. 프롬프트의 어느 영역이 불변이고 어느 영역이 가변인지 구분하는 컨텍스트 경계 분리(Boundary Segregation), 누적 해시가 깨지지 않도록 직렬화 순서를 통제하는 결정론적 직렬화(Deterministic Serialization), 그리고 20블록 룩백 한계와 5분/1시간 생명주기를 계산하여 리셋 주기를 설계하는 캐시 토폴로지 엔지니어링을 체득해야 합니다. 이와 같은 아키텍처 가드레일이 견고하게 확립될 때, AI 에이전트는 진정한 엔터프라이즈급 프로덕션 환경에서 지연과 비용의 두려움 없이 자율적인 가치를 창출할 수 있을 것입니다.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. Anthropic Prompt Caching Architecture & Key Invalidation Specifications
이 글과 함께 읽으면 좋은 인사이트



댓글 0