자동화 편향(Automation Bias)과 AI 검증: 엔지니어링 코드 리뷰의 비판적 검증 경계
이 글에서 먼저 가져갈 세 가지
AI 도구에 대한 과도한 의존이 엔지니어의 비판적 인지 회로를 마비시키는 메커니즘을 밝히고, 조직적 재앙을 방어하는 시스템적 검증 하네스를 제시합니다.
-
01
자동화 편향은 뇌의 에너지 절약 본능에서 발생합니다
인간의 뇌는 자동화 시스템의 제안을 마주할 때 숙고적 검증 회로를 끄고 권위 있는 기본값으로 수용하려는 인지적 구두쇠 기전에 갇힙니다. 본문 2절
-
02
누락 오류와 작위 오류라는 두 가지 치명적 함정이 시스템을 위협합니다
AI 린터나 보안 도구가 침묵할 때 문제를 놓치는 누락 오류와, 그럴듯한 AI의 환각을 비판 없이 승인하는 작위 오류가 결합하여 장애를 증폭시킵니다. 본문 3절
-
03
주의력 훈계 대신 능동적 결함 주입과 인지적 책임성 하네스를 구축해야 합니다
의도적인 합성 버그 주입, 2-Key 승인 프로토콜, 실패 시나리오 작성 의무화를 통해 엔지니어의 능동적 의심을 시스템적으로 복원해야 합니다. 본문 5절
1. 녹색 체크의 함정: AI 코딩 시대에 엔지니어링 팀이 마주한 새로운 병목
소프트웨어 엔지니어링 환경은 최근 2~3년 사이 전례 없는 속도로 자동화되었습니다. GitHub Copilot, Cursor, Claude Code, OpenAI Codex와 같은 AI 코딩 에이전트는 이제 개발자의 키보드 입력을 앞서 나가며 수십 줄의 비즈니스 로직을 한 번에 생성합니다. 정적 분석기, 보안 취약점 스캐너, 자동화된 CI/CD 파이프라인은 풀 리퀘스트(PR)마다 수십 개의 녹색 체크마크(Green Checkmark)를 띄우며 코드가 안전하다고 보증하는 것처럼 보입니다.
그러나 많은 엔지니어링 조직에서 기이한 역설이 관찰되고 있습니다. AI를 도입한 후 기능 구현 속도는 2배 이상 빨라졌다고 보고되지만, 프로덕션 배포 후 발생하는 치명적인 런타임 장애, 동시성 레이스 컨디션, 데이터 정합성 결함의 빈도는 결코 줄어들지 않았습니다. 오히려 장애 사후 분석 회의에서 가장 자주 등장하는 탄식은 다음과 같습니다.
"AI 에이전트가 효과적으로 돌아간다고 주석까지 달아주었고, 린터와 자동 테스트도 모두 녹색 불이었는데 왜 이 엣지 케이스를 아무도 눈치채지 못했을까요?"
이 문제의 본질은 AI 모델의 매개변수 크기나 알고리즘의 결함에만 있지 않습니다. 본질은 자동화된 시스템의 출력을 마주한 인간 엔지니어의 뇌 안에서 일어나는 인지 신경학적 취약점, 즉 자동화 편향(Automation Bias)에 있습니다. 도구가 고도화될수록 인간은 검증자의 자리에서 스스로 내려와 수동적인 승인자로 전락합니다. 이 글에서는 인지 심리학과 인간공학(Human Factors)의 정밀한 연구를 바탕으로 자동화 편향의 신경학적 발생 기전을 해부하고, 엔지니어의 비판적 검증력을 구조적으로 복원하는 아키텍처 방어 설계를 제시합니다.
2. 뇌의 에너지 절약 본능: '자동화 편향(Automation Bias)'의 인지 신경학적 메커니즘
인간의 뇌는 체중의 약 2%에 불과한 무게를 차지하지만, 휴식 상태에서도 전신 에너지의 20% 이상을 소모하는 극도로 비싼 기관입니다. 진화 인지 심리학자 수잔 피스크(Susan Fiske)와 셸리 테일러(Shelley Taylor)는 인간의 뇌를 인지적 구두쇠(Cognitive Miser)로 정의했습니다. 뇌는 생존을 위해 복잡한 문제를 해결할 때마다 가능한 한 에너지를 적게 쓰는 지름길, 즉 휴리스틱(Heuristic)을 무의식적으로 선택합니다.
대니얼 카너먼(Daniel Kahneman)의 이중 처리 이론(Dual-Process Theory)에 따르면, 우리의 사고 체계는 빠르고 직관적이며 에너지를 거의 쓰지 않는 시스템 1(System 1)과, 느리고 논리적이며 깊은 집중과 에너지를 요구하는 시스템 2(System 2)로 나뉩니다. 복잡한 분산 시스템의 트랜잭션 격리 수준, 메모리 누수 위험, 비동기 호출 간격 등을 점검하는 행위는 고도의 시스템 2 연산 능력을 필요로 합니다.
그런데 화면에 AI 에이전트의 완성도 높은 코드 설명과 함께 '모든 테스트 통과'라는 자동화 피드백이 제시되면, 뇌는 단계적으로 시스템 2의 가동을 중단합니다. 자동화 도구는 뇌에게 "더 이상 비싼 에너지를 들여 검증할 필요가 없다"는 강력한 안전 신호(Safety Cue)로 작용하기 때문입니다.
Skitka, Mosier, & Burdick (1999)의 고전적 실증 연구에 따르면, 자동화 편향(Automation Bias)이란 인간 의사결정자가 스스로 능동적인 정보 탐색과 인지적 처리를 수행하는 대신, 자동화 시스템이 제공하는 단서를 체계적이고 검증 가능한 대체물(Heuristic Replacement)로 삼아 맹목적으로 수용하는 체계적 인지 오류를 의미합니다.
연구진은 비행 시뮬레이션 및 복잡한 의사결정 과제에서 자동화 지원 도구가 도입되었을 때 참가자들이 모니터링을 현저히 줄이고 시스템의 잘못된 권고를 그대로 따르는 현상을 정량적으로 증명했습니다. 중요한 것은 참가자들의 전문성이나 지적 능력이 부족해서가 아니라는 점입니다. 숙련된 전문가일수록 시스템의 과거 성공 경험이 축적될수록 자동화 신호를 절대적 기본값(Default)으로 신뢰하며 비판적 경계심을 해제했습니다.
소프트웨어 엔지니어링 현장에서도 정확히 동일한 현상이 발생합니다. AI 코딩 어시스턴트가 생성한 150줄의 코드를 리뷰할 때, 백지상태에서 코드를 읽는 것과 달리 뇌는 이미 "이 코드는 AI가 최적화하여 작성한 정답"이라는 앵커링(Anchoring)에 사로잡힙니다. 결과적으로 코드의 표면적인 문법적 매끄러움에 만족한 채, 깊은 비즈니스 불변식(Invariants)을 검증하는 전두엽의 비판적 회로는 완전히 절전 모드로 진입합니다.
3. 누락 오류와 작위 오류: 시스템 붕괴를 초래하는 두 가지 치명적 실패 경로
Parasuraman & Manzey (2010)는 인간과 자동화의 상호작용 연구에서 자동화 편향이 초래하는 치명적 실수를 두 가지 뚜렷한 범주로 분류했습니다:
- 누락 오류 (Errors of Omission)
- 작위 오류 (Errors of Commission)
이 두 오류는 소프트웨어 아키텍처와 프로덕션 안정성을 파괴하는 결정적 메커니즘으로 작동합니다.
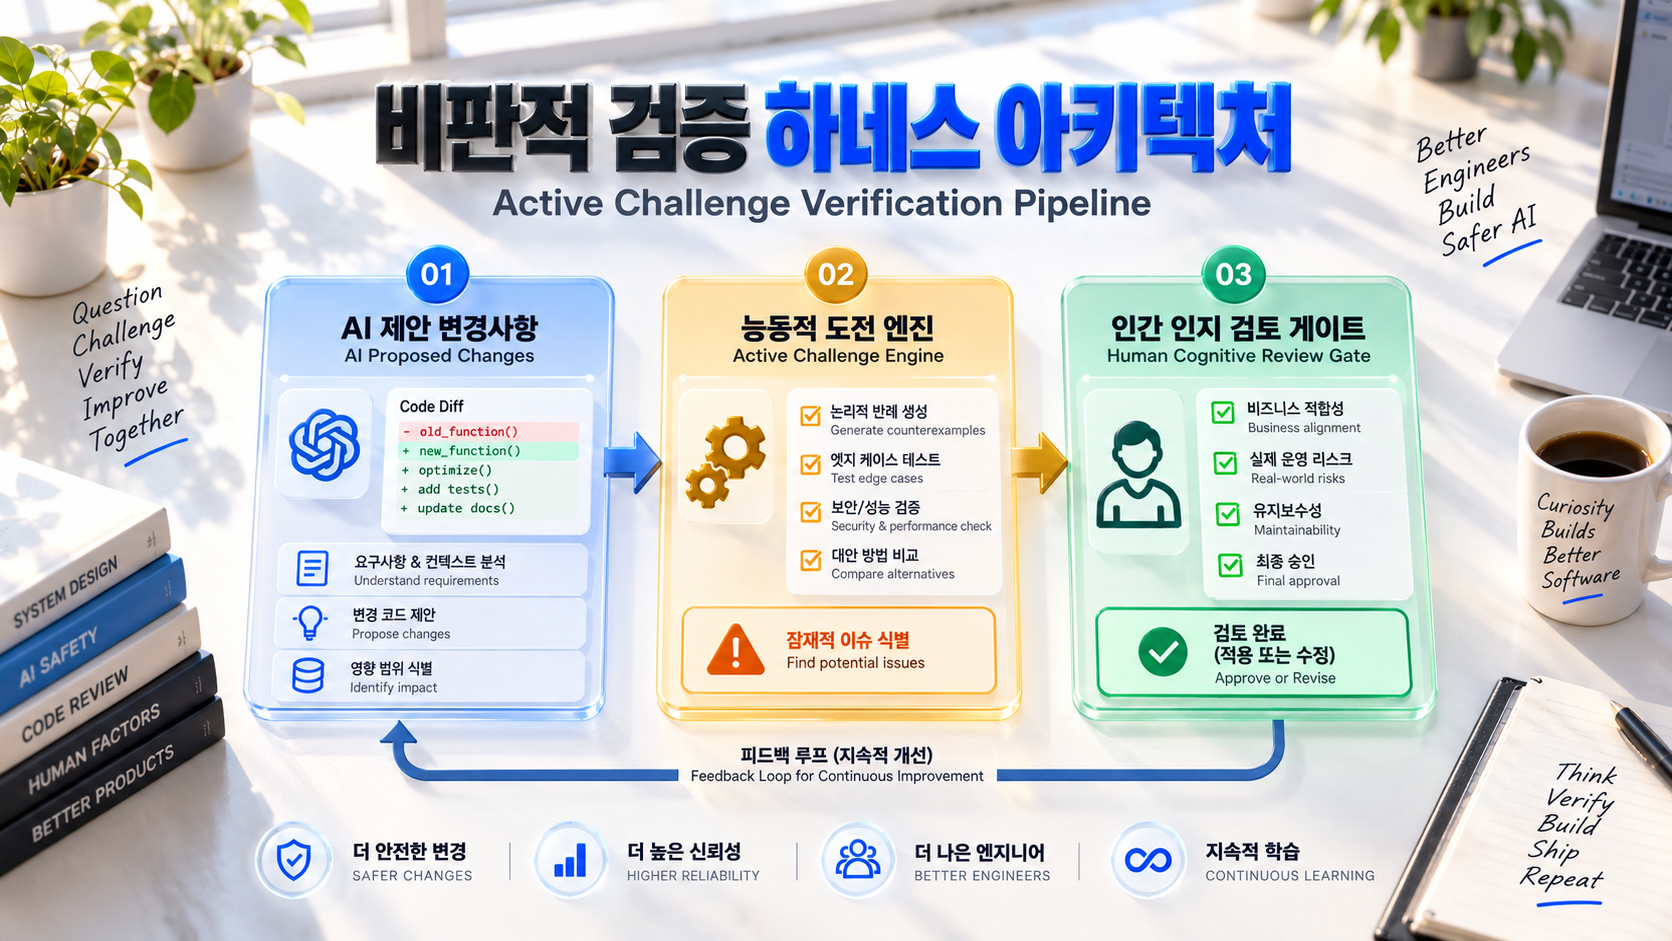
▲ AI 제안의 맹목적 수용을 차단하고 능동적 결함 주입과 2-Key 승인을 강제하는 비판적 검증 하네스 파이프라인
1) 누락 오류 (Errors of Omission): 도구의 침묵을 시스템의 무결성으로 오판하는 오류
누락 오류는 자동화 시스템이 특정 위험이나 결함을 감지하지 못하고 침묵했을 때, 인간 검증자 역시 감시와 검토를 게을리하여 문제를 발견하지 못하고 지나치는 현상입니다.
소프트웨어 개발에서 흔히 목격되는 사례는 다음과 같습니다:
- 보안 스캐너의 침묵: 의존성 취약점 분석 도구(SAST/DAST)가 제로데이 취약점이나 복잡한 인가(Authorization) 누락을 잡지 못했을 때, 리뷰어는 "스캐너가 아무 경고도 띄우지 않았으니 권한 검증 로직이 완벽할 것"이라고 지레짐작하고 코드를 머지합니다.
- 단위 테스트 통과의 착시: AI가 생성한 테스트 코드는 대개 행복 경로(Happy Path)만을 검증합니다. 코드 커버리지 지표가 90%를 기록하더라도 분산 트랜잭션의 타임아웃, 네트워크 단절 시의 멱등성 보장 여부는 전혀 테스트되지 않았음에도, 커버리지 숫자의 녹색 불빛이 엔지니어의 의구심을 잠재웁니다.
- 도구에 대한 과도한 위임(Complacency): 자동화 테스트를 통과했다는 사실이 "내가 더 이상 수동으로 코너 케이스를 추론할 필요가 없다"는 면죄부로 둔갑합니다.
2) 작위 오류 (Errors of Commission): 도구의 잘못된 지시를 반대 증거를 무시한 채 따르는 오류
작위 오류는 자동화 시스템이 부적절하거나 잘못된 판단을 권고했음에도 불구하고, 인간이 명백한 반대 증거나 상충하는 단서를 무시한 채 시스템의 지시를 그대로 행동으로 옮기는 현상입니다.
소프트웨어 개발에서의 작위 오류는 치명적인 파괴력을 지닙니다:
- 환각된 라이브러리 및 API 매개변수 승인: AI 에이전트가 존재하지 않거나 동작 방식이 다른 메서드를 자신 있게 권고했을 때, 엔지니어는 공식 문서를 대조하거나 직접 인터페이스를 확인하지 않고 "AI가 추천했으니 당연히 유효한 옵션일 것"이라며 설정 파일에 반영합니다.
- 동시성 환경에서의 잘못된 잠금 해제: 고트래픽 환경에서 락(Lock) 경합을 줄이겠다며 AI가 제안한 비원자적(Non-atomic) 캐시 갱신 코드를, 벤치마크나 데이터 정합성 시뮬레이션 없이 "지연 시간을 단축한다"는 AI의 달콤한 요약 문구에 속아 그대로 프로덕션에 적용합니다.
- 책임 분산(Diffusion of Responsibility): 결함이 발생했을 때 내면에서 "내가 짠 게 아니라 AI와 자동화 도구가 추천한 것이니 내 실수가 아니다"라는 무의식적 방어기제가 작동하여 검증에 대한 심리적 오너십이 증발합니다.
자동화 도구의 신뢰도가 70%일 때보다 95%로 높아질 때 인간의 자동화 편향은 기하급수적으로 악화됩니다. 가끔 틀리는 시스템 앞에서는 인간이 긴장하지만, 대부분 맞추는 시스템 앞에서는 인간의 뇌가 감시 자체를 완전히 포기하기 때문입니다.
4. 의지력에 기댄 주의력의 한계: 왜 '더 꼼꼼히 보라'는 훈계는 우선적으로 실패하는가
장애가 발생한 뒤 엔지니어링 리더십이 내놓는 가장 흔하고도 무력한 처방은 "코드 리뷰를 더 꼼꼼히 하라"거나 "AI가 짠 코드는 두 번 이상 의심하고 확인하라"는 구두 경고입니다. 하지만 인지과학의 관점에서 이러한 훈계는 체계적이고 검증 가능한 인지적 무지에 불과합니다.
인간의 주의 집중 자원은 한정되어 있으며, 업무 피로도, 마감 압박, 멀티태스킹 환경 속에서 의지력만으로 뇌의 생물학적 에너지 절약 메커니즘을 이겨낼 수는 없습니다. 하루에 수천 줄의 코드가 AI에 의해 쏟아지는 환경에서 리뷰어에게 "모든 줄을 의심하라"고 요구하는 것은, 초속 50미터의 강풍 속에서 촛불을 켜두라고 명령하는 것과 다름없습니다.
또한 체크리스트의 단순 추가 역시 역효과를 낳습니다. 항목이 20개가 넘어가는 긴 체크리스트를 쥐여주면, 개발자는 각 항목을 비판적으로 숙고하는 것이 아니라 기계적으로 모든 상자에 체크(Tick-box Mentality)를 누르는 또 다른 자동화 편향의 덫에 빠집니다.
결국 해결책은 인간의 주의력이나 도덕적 책임감에 호소하는 것이 아니라, 인간의 뇌가 시스템 2를 강제로 가동하지 않고는 다음 단계로 넘어갈 수 없도록 설계된 시스템적 검증 하네스(Systemic Verification Harness)를 파이프라인 레벨에 구축하는 것뿐입니다.
5. 비판적 검증 하네스(Active Challenge Harness): 능동적 의심을 강제하는 아키텍처 설계
자동화 편향을 무력화하기 위해 편집부에서는 다음의 3단계 비판적 검증 하네스(Active Challenge Harness) 아키텍처를 제안합니다. 이 아키텍처는 AI가 제시한 코드나 설정을 격리된 샌드박스에 가두고, 시스템적으로 인간의 능동적 반증(Falsification)을 요구합니다.
+-----------------------------------------------------------------------------------+
|                        비판적 검증 하네스 파이프라인                                 |
+-----------------------------------------------------------------------------------+
                                          |
                                          v
+-----------------------------+       +-----------------------------+
|    AI 제안 인입 격리 단계     | ----> |     능동적 결함 주입 엔진    |
| (Sandbox Quarantine Phase)  |       |   (Active Mutation Engine)  |
| - 원본 저장소 직접 머지 차단   |       | - 무작위 합성 결함 5% 주입    |
| - AI 생성 코드 메타데이터 태깅|       | - 카나리아 테스트 케이스 은폐 |
+-----------------------------+       +-----------------------------+
                                                     |
                                                     v
+-----------------------------+       +-----------------------------+
|    안전한 프로덕션 머지     | <---- | 2-Key 인지적 책임성 게이트  |
|    (Verified Deployment)    |       | (Cognitive Accountability)  |
| - 정합성 보장 릴리스        |       | - 3대 실패 가설 작성 필수   |
| - 지속적 편향 메트릭 모니터링|       | - 독립 인간 리뷰어 교차 승인|
+-----------------------------+ +-----------------------------+이 하네스의 3대 핵심 기둥은 다음과 같습니다:
1) 능동적 변이 및 결함 주입 (Active Fault Injection)
항공 산업의 조종사 훈련 시뮬레이터에서는 조종사가 계기판의 자동 항법 장치를 맹신하지 않도록 예고 없는 가상 고장을 주기적으로 주입합니다. 마찬가지로 CI 파이프라인에서 AI 생성 코드가 제출되었을 때, 시스템은 의도적으로 경미한 논리 오류나 비즈니스 규칙 위반(예: 경계값 ±1 오류, 무효한 널 처리)을 포함하는 합성 결함(Synthetic Fault)을 낮은 확률(예: 5%)로 임의 주입합니다.
리뷰어가 이 주입된 결함을 찾아내어 거부하지 않고 '원클릭 승인(Approve)'을 누르면, 파이프라인은 승인을 차단하고 "자동화 검증 경계 실패: 주입된 합성 결함이 감지되지 않았습니다"라는 경고를 띄웁니다. 이 메커니즘은 리뷰어의 뇌에 "언제든 AI 코드에 결함이 숨어 있을 수 있다"는 실질적인 인지적 긴장감을 지속적으로 유지시킵니다.
2) 반대 가설 생성기 (Devil's Advocate Prompting)
AI 에이전트가 코드를 생성할 때, 칭찬 일색의 코드 설명 대신 "이 코드가 프로덕션 환경에서 실패할 수 있는 3가지 치명적 시나리오"를 의무적으로 함께 생성하여 PR 상단에 붉은색 경고 박스로 출력하도록 강제합니다.
예컨대 "이 코드는 DB 커넥션 풀이 고갈되었을 때 스레드 블로킹을 유발할 수 있습니다", "네트워크 지연이 500ms 이상 발생하면 분산 락 갱신 실패로 중복 결제가 발생할 수 있습니다"와 같은 반대 증거(Counter-evidence)를 첫 화면에 노출함으로써, 리뷰어가 긍정 편향(Confirmation Bias)에 빠지는 것을 방지하고 단계적으로 시스템 2의 위험 분석 회로를 작동시킵니다.
3) 2-Key 인지적 책임성 게이트 (Cognitive Accountability Gate)
단순한 'LGTM(Looks Good To Me)'이나 'Approve' 버튼 클릭을 원천 차단합니다. AI 제안 코드를 승인하기 위해서는 검증자가 다음 질문에 직접 최소 100자 이상의 기술적 근거를 타이핑해야만 머지 버튼이 활성화됩니다:
- "이 코드에서 AI가 고려하지 못한 비즈니스 예외 상황은 무엇이며, 어떻게 검증했는가?"
- "이 변경이 롤백되어야 할 때 데이터 유실 없이 복구 가능한가?"
자신의 이름을 걸고 구체적인 판단 근거를 서술하도록 강제하는 제도는 사회 심리학에서 입증된 인지적 책임성(Accountability)을 극대화하여, 무의식적 승인 클릭을 원천적으로 봉쇄합니다.
6. 실무 적용 템플릿: AI 제안 병합을 위한 '인지적 책임성(Cognitive Accountability)' 리뷰 프로토콜
아키텍처 변경이나 기능 추가 시 엔지니어링 조직이 GitHub PR 템플릿 또는 코드 리뷰 워크플로우에 즉시 복사하여 도입할 수 있는 실무 검증 프로토콜 양식을 제공합니다.
# 🛡️ AI 생성 코드 비판적 검증 프로토콜 (Cognitive Accountability Protocol)

- **안내**: 본 PR은 AI 코딩 어시스턴트의 제안을 포함하고 있습니다. 자동화 편향(Automation Bias) 방지를 위해 아래 항목을 검증자가 직접 기술하지 않으면 머지가 차단됩니다.

## 1. 변경 요약 및 AI 관여 범위

- **AI 관여 비율**: [예: 로직 전체 80% / 보일러플레이트 20%]
- **사용 모델/도구**: [예: Claude Code / GitHub Copilot / Cursor]
- **주요 생성 파일 경로**: `src/...`

## 2. 누락 오류(Omission) 방어: 도구가 검증하지 않은 엣지 케이스

- [ ] 정적 분석기와 단위 테스트가 침묵한 영역을 확인했습니까?
- **확인된 사각지대**:
  - [예: 동시 접속 10,000건 발생 시 레디스 캐시 스탬피드 위험]
  - [예: 외부 결제 게이트웨이 타임아웃 발생 시 트랜잭션 롤백 누락 여부]

## 3. 작위 오류(Commission) 방어: AI 제안 중 의심하고 수정한 사항

- [ ] AI가 권고한 알고리즘이나 설정 중 실제 시스템 스펙과 충돌한 부분이 있었습니까?
- **직접 수정한 결함/환각**:
  - [예: 존재하지 않는 DB 인덱스 힌트 파라미터 삭제]
  - [예: Thread.sleep 기반 재시도를 Exponential Backoff로 교체]

## 4. 인지적 책임성 검증자의 최종 서명

- **검증 실행 명령**: `mvn test -Dtest=*ConcurrencyTest` 또는 `npm run test:mutation`
- **검증자 소견**: "본 코드가 실패할 수 있는 장애 시나리오 1건을 검토하였으며, 해당 상황에 대한 방어 로직이 정상 작동함을 확인했습니다."
- **검증자**: [홍길동 / Staff Engineer]7. 결론: 도구의 주권을 회복하는 엔지니어의 비판적 사고
소프트웨어 엔지니어링의 역사는 추상화의 역사이자 자동화의 역사였습니다. 천공 카드에서 어셈블리어로, 고급 프로그래밍 언어에서 클라우드 인프라와 AI 에이전트로 도구의 지능은 눈부시게 진화했습니다. 그러나 시스템이 아무리 똑똑해져도 시스템이 실패했을 때 책임을 지고 복구해야 하는 주체는 언제나 인간 엔지니어입니다.
자동화 편향은 나태함이나 역량 부족의 문제가 아닙니다. 그것은 고도화된 지능형 도구를 마주했을 때 작동하는 인간 뇌의 자연스러운 생물학적 취약점입니다. 이 취약점을 인정하지 않고 개인의 각성만을 요구하는 조직은 머지않아 AI가 만들어낸 그럴듯한 환각과 누락 오류의 쓰나미에 프로덕션 전체를 내어주게 될 것입니다.
진정한 시니어 엔지니어의 가치는 더 이상 '코드를 얼마나 빠르게 타이핑하는가'에 있지 않습니다. AI가 쏟아내는 수천 줄의 코드 앞에서 인지적 구두쇠의 달콤한 유혹을 뿌리치고, "이 시스템은 어디서, 왜 무너질 수 있는가?"라는 불편한 질문을 집요하게 던질 수 있는 비판적 사고력에 있습니다. 시스템 파이프라인에 비판적 검증 경계를 구축하고, 인간의 숙고적 이성을 회복하십시오. 그것이 AI라는 강력한 파도 위에서 엔지니어링의 품격과 시스템의 신뢰성을 지키는 유일한 길입니다.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. Parasuraman & Riley (1997) — Humans and Automation: Use, Misuse, Disuse, Abuse
이 글과 함께 읽으면 좋은 인사이트



댓글 0