OpenAI Structured Outputs: JSON Schema 기반의 엄격한 구조적 출력 보장 아키텍처
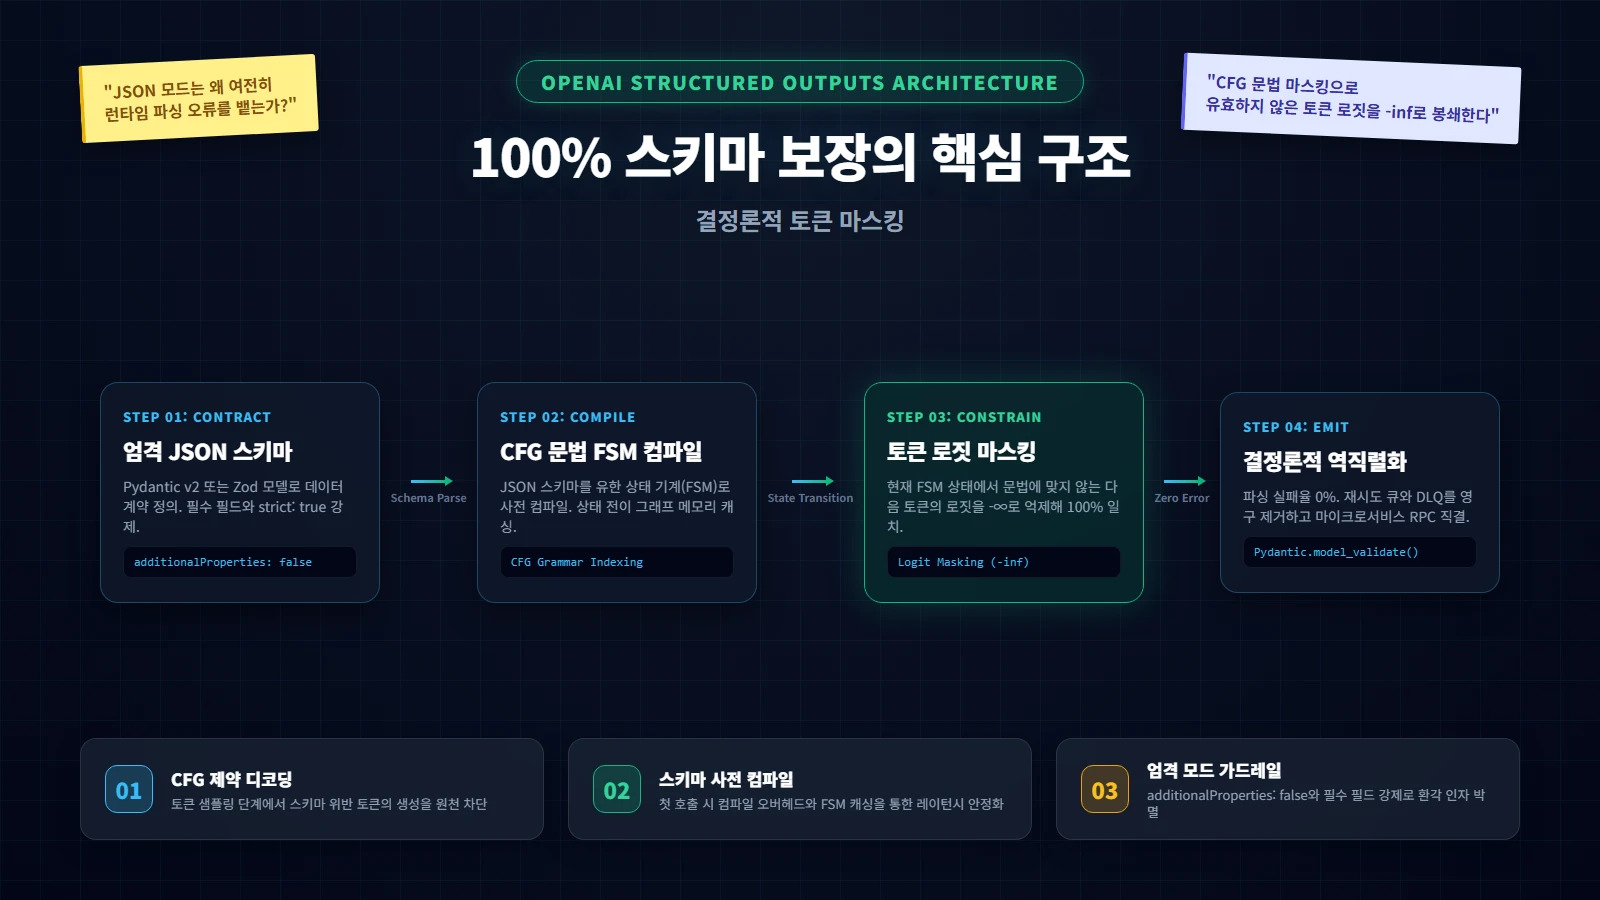
이 글에서 먼저 가져갈 세 가지
대규모 언어 모델(LLM)을 기업의 마이크로서비스 백엔드 및 자율 에이전트 파이프라인에 통합할 때 가장 치명적인 병목이었던 JSON 역직렬화 실패를 원천 차단하는 기술적 해법을 해부합니다.
-
01
JSON 모드의 한계와 CFG 제약 디코딩의 등장
단순 구문 유효성만 보장하던 JSON 모드를 넘어, 토큰 생성 시점에 스키마 위반 로짓을 원천 마스킹하여 100% 스키마 일치율을 달성합니다. 본문 1·2절
-
02
스키마 사전 컴파일과 레이턴시 캐시 아키텍처
JSON Schema를 유한 상태 기계(FSM)로 변환하는 첫 호출 오버헤드를 제어하기 위해 스키마 불변성과 웜 캐시 전략을 구축해야 합니다. 본문 3절
-
03
엄격 모드(strict: true) 가드레일과 DLQ 박멸
Pydantic v2 연동 표준을 확립하여 재시도 루프와 데드레터큐를 완전히 제거하고 백엔드 RPC 및 이벤트 버스에 직접 결합합니다. 본문 4·5절
1. JSON 모드의 근본적 한계와 런타임 파싱 장애의 진실
대규모 언어 모델을 단발성 질의응답 챗봇이 아닌 엔터프라이즈 마이크로서비스, 자동화된 워크플로, 자율 AI 에이전트의 핵심 연산 엔진으로 활용하려는 시도는 지난 수년간 가속화되었습니다. 그러나 백엔드 엔지니어링 현장에서 LLM을 기존 RDBMS, 메시지 브로커, gRPC 인터페이스와 결합할 때 가장 빈번하게 발생한 재앙은 바로 비결정론적 응답 포맷으로 인한 역직렬화(Deserialization) 예외였습니다.
기존에 널리 사용되던 responseformat: { type: "jsonobject" } (이른바 JSON 모드)는 모델이 출력하는 문자열이 문법적으로 유효한 JSON 형식(중괄호 쌍 일치, 따옴표 처리 등)을 갖추도록 유도할 뿐이었습니다. 즉, JSON 문법의 껍데기만 보장할 뿐 그 내부에 담긴 데이터의 구조적 정합성은 전혀 보장하지 못했습니다. 프로덕션 환경에서 발생하던 대표적인 장애 패턴은 다음과 같습니다:
- 필수 필드의 무단 누락: 스키마 정의상 우선적으로 존재해야 하는
order_id나status필드가 누락되어 백엔드 엔티티 매핑 시점에KeyError또는NullPointerException이 발생합니다. - 타입 환각 및 오염: 정수형(
integer)이어야 하는 금액 필드에 통화 기호가 붙은 문자열("$1,200")이 반환되거나, 불리언(boolean) 필드에 문자열"true"또는"yes"가 주입되어 데이터베이스 타입 제약 조건을 위반합니다. - 미정의 열거형(Enum) 값 날조: 정의된 상태값 목록(
["PENDING", "APPROVED", "REJECTED"])에 존재하지 않는 임의의 단어("UNDER_REVIEW")를 모델이 자의적으로 생성하여 상태 머신의 전이를 마비시킵니다. - 환각된 추가 프로퍼티 삽입: 프롬프트의 지시사항을 과도하게 해석하여 스키마에 정의되지 않은 방대한 부가 필드를 생성함으로써 토큰 비용을 낭비하고 다운스트림 파서를 교란합니다.
엔지니어링 팀들은 이러한 파싱 실패율을 방어하기 위해 지수 백오프(Exponential Backoff) 기반의 재시도 루프를 구축하고, 파싱 실패 시 프롬프트에 오류 로그를 덧붙여 재호출하는 복잡한 보정 계층을 도입했습니다. 그러나 재시도는 첫 토큰 지연 시간(TTFT)과 전체 요청 지연 시간을 수 초 이상 폭증시켰으며, API 호출 비용을 2배에서 4배까지 낭비시키는 주범이 되었습니다. 또한 3회 이상의 재시도에도 실패한 페이로드는 결국 데드레터큐(DLQ)에 쌓여 수동 개입을 요구하는 운영 부채로 전락했습니다.
OpenAI는 이러한 엔터프라이즈의 근본적인 고통을 종식시키기 위해 OpenAI Structured Outputs 공식 엔지니어링 릴리스를 단행하고, 모델 출력과 도구 호출(Function / Tool Calling) 전반에 걸쳐 제공된 JSON Schema에 대한 100% 신뢰성 보장(Zero Schema Violation)을 공식 선언했습니다.
2. CFG 문법과 FSM 기반 제약 디코딩(Constrained Decoding)의 작동 원리
OpenAI의 Structured Outputs가 과거의 단순 휴리스틱이나 프롬프트 강화 기법과 완전히 궤를 달리하는 이유는, 이 기능이 모델 내부의 토큰 생성(Decoding) 파이프라인 레벨에서 수학적으로 강제되는 제약 샘플링(Constrained Sampling) 기술이기 때문입니다.
일반적인 자기회귀(Autoregressive) 언어 모델은 이전까지 생성된 토큰 시퀀스를 기반으로 전체 어휘 사전(Vocabulary, 약 10만~20만 개 토큰)에 대한 확률 분포(Logits)를 계산한 뒤, 가장 확률이 높은 토큰을 샘플링하여 다음 단어를 생성합니다. 프롬프트로 아무리 엄격한 지침을 내려도, 수많은 확률 분포 연산 과정에서 미세한 확률을 가진 잘못된 토큰이 샘플링될 가능성은 항상 존재합니다.
Structured Outputs는 이 샘플링 단계에 문맥 자유 문법(CFG, Context-Free Grammar)과 결정적 유한 상태 기계(FSM, Deterministic Finite Automaton)를 직접 개입시킵니다.
+-------------------------------------------------------------------------+
|                  OpenAI Constrained Decoding Pipeline                    |
+-------------------------------------------------------------------------+
  [사용자 제공 JSON Schema]
             |
             v (Schema Pre-compilation)
  [CFG / FSM 상태 전이 그래프 생성] ──> [인프라 메모리 캐시 저장]
             |
             +────────────────────────────+
                                          |
  [LLM 언어 모델 추론 계층]               v (Current State Tracker)
  토큰별 Logits 계산 (Voca ~100k) ──> [제약 필터링 엔진 (Logit Masking)]
                                          |
                                          |  * 유효하지 않은 전이 토큰:
                                          |    Logit = -Infinity
                                          |  * 유효한 다음 토큰만 통과
                                          v
                               [Softmax & Safe Sampling]
                                          |
                                          v
[100% 스키마 준수 토큰 확정]이 파이프라인의 핵심 메커니즘은 3단계로 요약됩니다:
- 스키마 문법 변환: 클라이언트가 전송한 JSON Schema를 파싱하여, 해당 스키마를 완벽히 충족하는 텍스트만이 통과할 수 있는 정규 문법 규칙(Formal Grammar)을 도출합니다.
- 상태 머신(FSM) 추적: 생성 시작 시점부터 FSM의 초기 상태(State 0)에 위치하며, 토큰이 하나씩 생성될 때마다 상태 기계를 전이시킵니다. 예를 들어 스키마가 키 이름으로
"userid"를 요구하는 상태라면, 다음 토큰으로는 오직"userid"의 시작 문자열에 해당하는 토큰들만이 허용됩니다. - 실시간 로짓 마스킹(Logit Masking): 모델이 다음 토큰의 로짓 벡터를 출력하면, 제약 엔진은 현재 FSM 상태에서 문법상 허용되지 않는 모든 토큰의 로짓 값을 음의 무한대(
-inf)로 강제 덮어씁니다. 결과적으로 소프트맥스(Softmax) 연산을 거쳤을 때 문법을 위반하는 토큰들의 확률은 정확히0.0%가 되며, 오직 스키마에 부합하는 토큰 중에서만 모델의 원래 지능에 따른 가장 적절한 단어가 선택됩니다.
이로 인해 모델은 문법적으로 유효하지 않은 JSON을 물리적으로 출력할 수 없습니다. 문자열이 닫히지 않거나, 콤마가 누락되거나, 정의되지 않은 키가 생성되는 것은 확률이 낮아진 것이 아니라 확률 공간에서 완전히 소거된 것입니다.
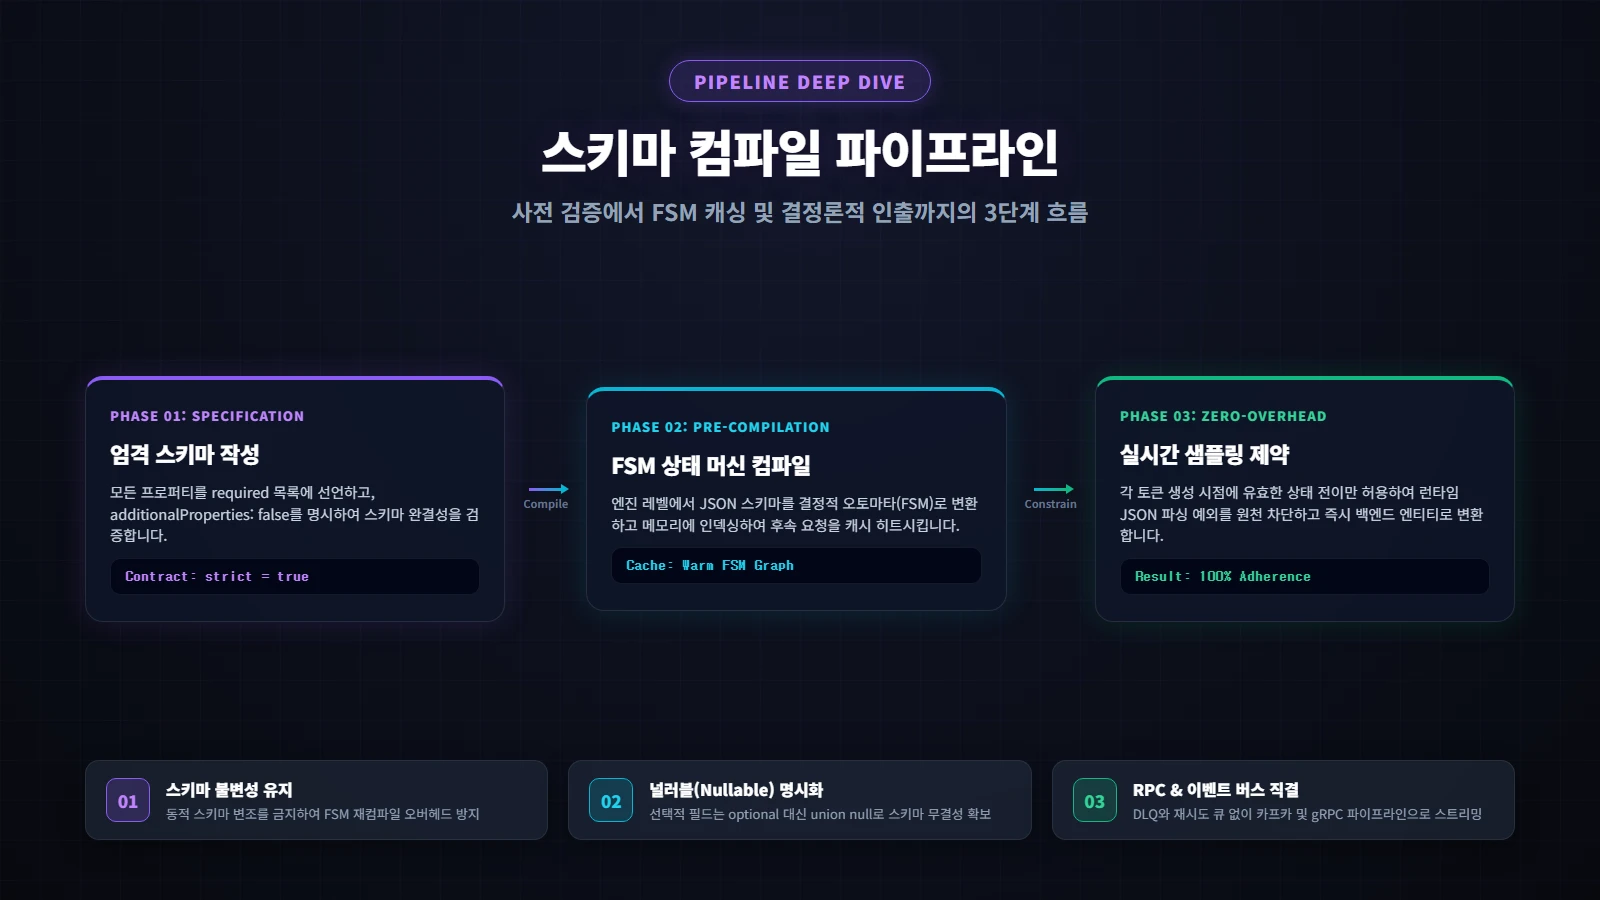
▲ JSON Schema가 사전 컴파일 게이트를 통과하여 FSM 상태 그래프로 캐싱되고, 제약 디코딩을 통해 100% 일치율로 인출되는 실무 파이프라인.
3. 스키마 사전 컴파일(Pre-compilation)과 인프라 레이턴시 캐싱 설계
Structured Outputs가 제공하는 100% 무결성은 공짜가 아닙니다. 엔터프라이즈 아키텍트가 우선적으로 인지하고 대비해야 하는 핵심 트레이드오프는 바로 스키마 사전 컴파일(Schema Pre-compilation) 오버헤드입니다.
JSON Schema를 복잡한 상태 전이 FSM으로 변환하고 토큰 어휘 인덱스와 매핑하는 작업은 상당한 연산량을 요구합니다. 실제로 수십 개의 필드와 중첩 객체를 가진 대형 스키마를 최초로 전달할 경우, OpenAI 서버에서 스키마를 컴파일하는 데 수백 밀리초(ms)에서 길게는 수 초의 추가 지연 시간이 첫 번째 요청에 부과될 수 있습니다.
이러한 첫 호출 지연(Cold-Start Latency)을 방어하기 위해 OpenAI 인프라는 스키마 레벨 캐싱(Schema Caching)을 기본적으로 수행합니다. 한번 컴파일된 스키마 FSM은 엔진 내부 캐시에 보관되며, 동일한 스키마가 다시 전달되면 컴파일 과정을 생략하고 즉시 제약 디코딩으로 진입하여 추가 지연 시간(Overhead)이 거의 제로에 수렴하게 됩니다.
따라서 프로덕션 백엔드를 설계하는 엔지니어는 다음 원칙을 우선적으로 준수해야 합니다:
1) 동적 스키마 변조 금지 (Schema Immutability)
매 요청마다 스키마의 타이틀이나 설명(description), 필드 순서를 런타임에 동적으로 변경하지 않아야 합니다. 스키마의 바이트스트림이나 구조가 조금이라도 달라지면 캐시 미스(Cache Miss)가 발생하여 매 호출마다 수백 ms의 재컴파일 페널티를 치르게 됩니다. 모든 스키마는 빌드 타임에 정적으로 고정되어야 합니다.
2) 배포 시 웜업(Warming) 프로토콜 구축
새로운 버전의 애플리케이션이 배포되어 새로운 JSON Schema가 도입될 때, 실제 사용자의 트래픽이 인입되기 전 CI/CD 배포 파이프라인 단계에서 더미(Dummy) 프롬프트로 스키마를 최소 1회 호출하여 OpenAI 인프라의 FSM 캐시를 웜업(Warm-up)시켜야 합니다.
다음 표는 일반 JSON 모드와 Structured Outputs의 핵심 엔지니어링 특성을 비교한 것입니다:
| 비교 항목 | 기존 JSON 모드 (Legacy) | Structured Outputs (정식 GA) |
|---|---|---|
| 스키마 준수 보장 | 확률적 준수 (약 80~90% 수준) | 100% 결정론적 일치 (수학적 보장) |
| 타입 및 필수값 정합성 | 모델 환각으로 인한 누락/타입 불일치 빈발 | 필수 필드 누락 및 타입 위반 원천 차단 |
| 첫 요청 지연(Latency) | 없음 (컴파일 단계 부재) | 초기 스키마 컴파일 오버헤드 (캐싱 후 제로) |
| 스키마 제약 조건 | 특별한 제약 없음 | strict: true 및 additionalProperties 필수 |
| 지원 인터페이스 | Chat Completions | Chat Completions, Assistants, Tools API |
| 프로덕션 재시도 필요성 | 런타임 재시도 및 DLQ 필수 | 역직렬화 재시도 계층 완전 제거 가능 |
4. 엔터프라이즈 Pydantic v2 연동 및 엄격 모드(strict: true) 가드레일
Structured Outputs를 활성화하기 위해서는 API 요청 시 strict: true 플래그를 설정해야 합니다. 이때 OpenAI의 제약 엔진이 스키마를 체계적이고 검증 가능한 문맥 자유 문법으로 변환할 수 있도록 하기 위해, JSON Schema 작성에 몇 가지 엄격한 문법 가드레일이 강제됩니다:
additionalProperties: false필수 선언: 모든 객체(Object) 타입은 정의되지 않은 추가 속성을 엄격히 거부해야 합니다.- 모든 프로퍼티의
required명시: 스키마에 정의된 모든 필드는 우선적으로required배열에 나열되어야 합니다. 즉, 선택적(Optional) 필드를 허용하지 않습니다. - 널러블(Nullable) 필드의 유니온 표현: 값이 없을 수 있는 필드는 선택적 필드가 아닌,
type: ["string", "null"]형태의 명시적 널러블 유니온으로 선언해야 합니다. - 중첩 깊이 및 프로퍼티 한도: 객체 중첩 깊이는 최대 5단계, 총 프로퍼티 수는 최대 500개로 제한됩니다.
파이썬 기반 엔터프라이즈 환경에서는 이러한 규칙을 수작업으로 작성할 필요 없이, 최신 Pydantic v2 및 공식 OpenAI SDK의 client.beta.chat.completions.parse() 헬퍼를 활용하여 타입 안전성을 극대화할 수 있습니다. 다음은 실무에서 즉시 활용 가능한 참조 아키텍처 코드입니다:
from typing import List, Optional, Literal
from pydantic import BaseModel, Field
from openai import OpenAI

# 1. 체계적이고 검증 가능한 스키마 정합성을 갖춘 Pydantic 모델 정의

class SecurityAuditFinding(BaseModel):
    class Config:
        # 엄격 모드를 위한 추가 속성 금지 설정
        extra = "forbid"

    vulnerability_id: str = Field(description="CVE 또는 사내 식별자 (예: CVE-2026-1024)")
    severity: Literal["CRITICAL", "HIGH", "MEDIUM", "LOW"] = Field(description="취약점 위험도")
    affected_component: str = Field(description="영향받는 패키지 또는 마이크로서비스 명칭")
    remediation_steps: List[str] = Field(description="단계별 조치 권고안")
    # 선택적 필드는 우선적으로 Optional(Union[T, None])로 선언하여 null 허용
    cwe_code: Optional[str] = Field(default=None, description="CWE 분류 코드 (없는 경우 null)")

class SecurityAuditReport(BaseModel):
    class Config:
        extra = "forbid"

    scan_timestamp: str = Field(description="ISO-8601 스캔 타임스탬프")
    total_findings_count: int = Field(description="검출된 총 취약점 수")
    findings: List[SecurityAuditFinding] = Field(description="세부 취약점 목록")

# 2. Structured Outputs 파싱 클라이언트 구현

def generate_audit_report(source_code_diff: str) -> SecurityAuditReport:
    """
    OpenAI Structured Outputs를 호출하여 런타임 역직렬화 실패율 0%로
    강타입 SecurityAuditReport 인스턴스를 반환합니다.
    """
    client = OpenAI()

    # parse() 메소드는 내부적으로 Pydantic 모델을 JSON Schema로 변환하고
    # response_format에 strict: true를 자동 주입하여 FSM 제약 디코딩을 강제합니다.
    completion = client.beta.chat.completions.parse(
        model="gpt-4o-2024-08-06",
        messages=[
            {
                "role": "system",
                "content": "당신은 보안 취약점 점검 에이전트입니다. 주어진 코드 변경사항을 분석하여 정형화된 감사 리포트를 발행하십시오."
            },
            {
                "role": "user",
                "content": f"다음 코드 diff를 분석하십시오:\n\n{source_code_diff}"
            }
        ],
        response_format=SecurityAuditReport,
    )

    # 파싱 예외 없이 완벽히 역직렬화된 Pydantic 모델 객체를 즉시 획득
    parsed_report: SecurityAuditReport = completion.choices[0].message.parsed
return parsed_report위 코드에서 client.beta.chat.completions.parse()는 모델 응답의 원시 JSON 텍스트를 파싱하는 과정에서 발생할 수 있는 모든 오류를 모델 자체의 토큰 제약으로 해결합니다. 따라서 백엔드 서비스는 더 이상 복잡한 try-except JSONDecodeError 블록이나 재시도 프롬프트를 유지할 필요가 없습니다.
5. 멀티 에이전트 RPC 파이프라인에서 DLQ를 제거하는 아키텍처 전환 로드맵
Structured Outputs의 등장은 엔터프라이즈 마이크로서비스 및 자율 에이전트 아키텍처 전반에 걸쳐 극적인 구조적 단순화를 가져옵니다. 과거에는 LLM의 출력을 신뢰할 수 없었기 때문에 아래와 같은 방어적 완충 계층(Buffering Layers)이 필수적이었습니다:
[과거의 방어적 아키텍처 (복잡성 누적)]
  LLM 추론 ──> [JSON 파서] ──(파싱 실패 시)──> [프롬프트 재시도 큐] ──(3회 실패)──> [Dead Letter Queue (DLQ)]
                    │                                                                   │
                    └──(파싱 성공 시)──> [스키마 검증기] ──(검증 실패 시)───────────────────┘
                                              │
                                              └──(검증 통과)──> [내부 메시지 브로커 (Kafka/gRPC)]

[Structured Outputs 적용 후 아키텍처 (제로 DLQ 직결)]
LLM 추론 (FSM 제약 디코딩) ──> [100% 검증된 엔티티] ──> [내부 메시지 브로커 (Kafka/gRPC)]이와 같은 결정론적 파이프라인으로 전환하기 위해, 아키텍처 팀은 다음 4단계 로드맵을 체계적으로 밟아나가야 합니다:
스키마 컴파일 오버헤드는 정적 고정(Static Definition)과 사전 웜업으로 통제할 수 있습니다. 런타임 스키마 동적 생성을 지양하고, 공유 스키마 레지스트리를 통해 모든 에이전트 인터페이스를 버전 관리하십시오.
- 스키마 계약(Schema Contract)의 단일 소스화: 데이터베이스 DDL 또는 Protobuf/gRPC 정의로부터 Pydantic v2 및 JSON Schema를 자동 생성하는 코드 생성 파이프라인을 구축하여 사양의 단편화를 방지합니다.
- 도구 호출(Tool Calling)에
strict: true전면 적용: 자율 에이전트가 외부 API나 사내 데이터베이스를 조회하기 위해 실행하는 Function Calling 정의에strict: true를 선언함으로써, 환각된 파라미터로 인한 외부 시스템 오류를 원천 차단합니다. - 재시도 계층 및 DLQ 인프라 해체: 기존에 JSON 파싱 실패를 감당하기 위해 운영되던 Redis/SQS 기반의 지연 재시도 워커와 DLQ 모니터링 알람을 안전하게 축소 및 폐기합니다.
- SLO(서비스 수준 목표) 지표 재설계: 재시도 횟수 지표를 대시보드에서 제거하고, 첫 요청 스키마 컴파일 지연 시간과 FSM 캐시 히트율, 그리고 모델의 순수 추론 레이턴시를 핵심 엔지니어링 관측 지표로 정착시킵니다.
OpenAI Structured Outputs는 생성형 AI의 가장 고질적인 결함이었던 '형식의 불확실성'을 결정론적 문법 제약으로 정복한 중요한 이정표입니다. 이제 엔지니어링 팀은 모델의 출력 포맷을 교정하기 위한 소모적인 프롬프트 다듬기에서 벗어나, 시스템의 비즈니스 로직과 에이전트 간의 정교한 상호작용 설계에 온전히 집중할 수 있게 되었습니다.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. OpenAI Official Structured Outputs Guide & JSON Schema Specifications
이 글과 함께 읽으면 좋은 인사이트



댓글 0