읽기 복제본 신선도 계약 설계
이 글에서 먼저 가져갈 세 가지
복제 지연은 데이터베이스의 느린 순간이 아니라, 요청마다 허용 가능한 최신성을 판정해야 하는 제품·아키텍처 문제입니다.
- 01복제 지연은 단일 알람이 아니라 요청별 신선도 예산으로 해석해야 합니다.
결제 완료 화면과 전날의 통계 대시보드가 요구하는 최신성은 같지 않습니다. 본문 1절
- 02read-your-writes는 주 DB 고정이 아니라 제한된 우회 계약입니다.
사용자가 방금 만든 변경만 안전하게 읽게 하고, 우회 기간과 범위를 제한해야 합니다. 본문 2절
- 03라우팅은 복제 지연뿐 아니라 폴백 비용과 장애 반경까지 측정해야 합니다.
주 DB 우회율이 늘면 지연 문제를 정합성 문제로 바꾼 것에 불과할 수 있습니다. 본문 3·4절
1. ‘복제 지연이 1초인데 왜 주문 직후에는 치명적일까?’ 최신성 요구를 요청 단위로 분리하는 법
읽기 복제본은 주 DB의 읽기 부하를 덜고 장애 복구 선택지를 넓히는 훌륭한 수단이다. 그러나 비동기 복제 환경에서 복제본은 주 DB와 같은 시점의 데이터를 보장하지 않는다. PostgreSQL의 Hot Standby 문서는 주 DB와 대기 서버에서 거의 같은 시점에 실행한 쿼리가 서로 다른 결과를 낼 수 있으며, 대기 서버의 데이터는 결국 주 DB와 일치한다고 설명한다. 즉 읽기 복제본의 정확한 속성은 “빠른 사본”이 아니라 시간차가 있는 사본이다.
문제는 지연의 절대값만으로 위험을 판단하려 할 때 시작한다. 복제 지연이 1초여도 상품 검색 결과에는 거의 영향이 없을 수 있다. 반면 사용자가 배송지를 수정한 직후의 주문 확인, 권한을 회수한 직후의 접근 검사, 잔액을 반영한 직후의 결제 화면에서는 수백 밀리초의 오래된 읽기도 제품 약속을 깨뜨린다. 인프라 팀이 replicalagseconds 하나에 경보를 걸고, 애플리케이션 팀이 모든 조회를 복제본으로 보내는 구조에서는 이 차이를 표현할 방법이 없다.
- [ ] 쓰기 직후의 화면과 오래된 데이터가 허용되는 조회가 같은 DB 엔드포인트를 사용합니까?
- [ ] 복제 지연 알람은 있지만, 어떤 사용자 흐름이 그 지연을 견딜 수 있는지 정의돼 있지 않습니까?
- [ ] 지연이 커지면 모든 읽기를 주 DB로 돌리는 것 외의 대응책이 없습니까?
- [ ] 복제본에서 긴 조회가 취소될 수 있다는 사실을 애플리케이션 재시도 정책이 모르고 있습니까?
신선도 계약은 거대한 분산 트랜잭션을 뜻하지 않는다. 각 읽기 경로에 “이 응답은 몇 초 전의 상태까지 허용되는가”, “방금 성공한 쓰기를 반드시 볼 필요가 있는가”, “기준을 만족하지 못하면 실패·대기·주 DB 우회 중 무엇을 할 것인가”를 정하는 일이다. 예를 들어 카탈로그 목록은 30초의 지연을 허용할 수 있지만, 회원이 자신의 프로필을 저장한 직후에는 해당 사용자에 한해 최신 쓰기를 보장해야 할 수 있다. 이 경계를 API·유스케이스 수준에서 명시하면 복제 지연은 모호한 운영 위험이 아니라 라우팅 입력값이 된다.
여기서 한 단계 더 중요한 사실이 있다. “항상 최신값”은 공짜 옵션이 아니다. 멀리 떨어진 리전에 동기 복제를 강제하거나 모든 읽기를 주 DB로 묶으면 쓰기 지연과 주 DB의 장애 반경이 함께 커진다. AWS의 멀티 리전 가이드도 일관성·가용성·추가 지연 사이의 트레이드오프를 애플리케이션 설계에서 다뤄야 한다고 설명한다. 따라서 목표는 전체 시스템을 강하게 일관되게 만드는 것이 아니라, 강한 최신성이 필요한 작은 요청 집합을 정확히 골라내는 데 있다.
그렇다면 요청은 자신이 필요한 최신성을 어떻게 서버에 전달하고, 라우터는 복제본이 그 조건을 충족했는지 어떻게 판정할까? 핵심은 시간만 비교하지 않고 커밋의 진행 위치를 함께 관리하는 데 있다.
2. ‘방금 저장한 값은 어떻게 복제본에서 보장할까?’ 커밋 위치와 읽기 라우팅의 내부 경로
비동기 복제는 대체로 주 DB가 변경 로그를 기록하고, 복제본이 그 로그를 받아 적용하는 경로로 동작한다. PostgreSQL에서는 WAL이 이 역할을 맡는다. 쓰기가 성공했다는 응답은 주 DB의 커밋을 의미할 뿐, 복제본이 그 레코드를 이미 적용했다는 뜻은 아니다. 따라서 단순히 “쓰기 후 3초 동안 주 DB를 사용한다”는 TTL 방식은 쉬우나, 정상 상태에서는 불필요하게 주 DB를 쓰고 지연이 길어진 장애 상태에서는 충분하지 않을 수 있다.
더 정확한 모델은 쓰기 성공 시점의 커밋 위치를 얻고, 읽을 후보 복제본의 적용 위치와 비교하는 것이다. 복제본이 요청이 요구한 위치 이상을 적용했다면 그 복제본에서 읽어도 해당 쓰기보다 오래된 결과를 받지 않는다. 아직 따라오지 못했다면 짧게 대기하거나 주 DB로 우회한다. 이 방식은 특정 데이터베이스의 API 하나에 종속된 패턴이 아니다. 변경의 진행 위치 또는 버전을 갖고, 사본이 그 버전을 통과했는지 확인하는 구조다.
[Write Request]
       |
       v
[Primary DB commits version V] ----> response carries requiredVersion=V
       |
       +---- replication stream ----> [Replica applied version R]
                                         |
[Read Request + requiredVersion V] ------+
                                         v
R >= V ? [Replica read] : [bounded wait / primary fallback]requiredVersion은 모든 클라이언트가 영구히 들고 다녀야 하는 전역 토큰이 아니다. 사용자가 방금 성공시킨 쓰기와 이어지는 짧은 읽기 흐름, 또는 서버 내부의 한 요청 체인처럼 실제로 read-your-writes가 필요한 범위에서만 전파한다. 쿠키·세션·헤더·서버 측 요청 컨텍스트 중 어느 방식을 선택할지는 개인정보, 다중 디바이스 동기화, API 게이트웨이 구성에 따라 달라진다. 공통 원칙은 하나다. 버전 토큰의 수명과 대상이 넓어질수록 주 DB 우회율과 운영 복잡성이 함께 커지므로, 제품 약속보다 넓게 전파하지 않는다.
type Freshness =
  | { mode: 'eventual'; maxStalenessMs: number }
  | { mode: 'read-your-writes'; requiredVersion: string; waitBudgetMs: number };

async function routeRead(freshness: Freshness) {
  const replica = chooseHealthyReplica();
  const appliedVersion = await replica.appliedVersion();

  if (freshness.mode === 'eventual' && replica.lagMs() <= freshness.maxStalenessMs) {
    return replica;
  }
  if (freshness.mode === 'read-your-writes' && appliedVersion >= freshness.requiredVersion) {
    return replica;
  }
  if (freshness.mode === 'read-your-writes' && freshness.waitBudgetMs > 0) {
    return waitUntilApplied(replica, freshness.requiredVersion, freshness.waitBudgetMs);
  }
  return primary();
}이 코드는 원리를 보이기 위한 의사 코드다. 실제 비교 함수는 로그 위치·단조 증가 버전·데이터베이스가 제공하는 복제 상태 API에 맞춰 구현해야 하며, 문자열 비교로 순서를 판단해서는 안 된다. 또한 waitUntilApplied는 요청 스레드를 무제한으로 붙잡아 두면 안 된다. 대기 예산을 넘겼을 때는 주 DB 우회, 명시적 재시도 응답, 또는 작업 완료 화면으로 전환하는 제품 정책 중 하나를 선택해야 한다.
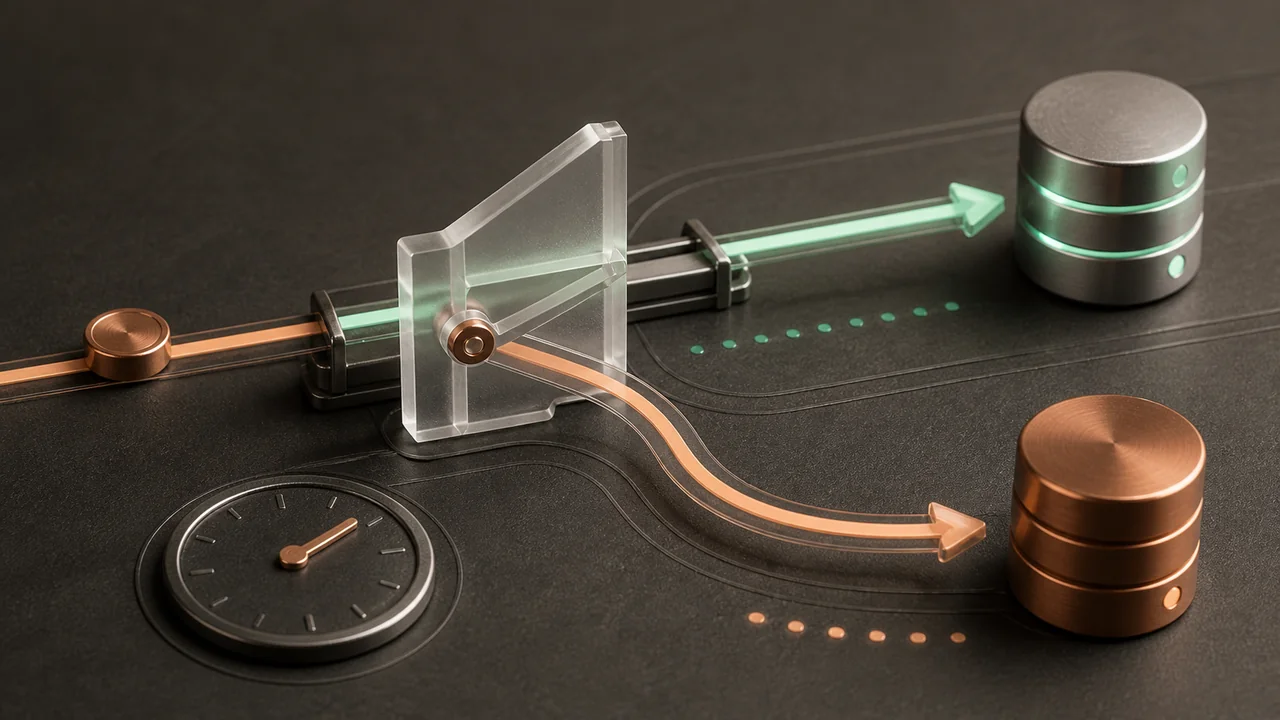
▲ 요청이 요구한 최신성을 만족하는 경우에만 복제본으로 보내고, 그렇지 않으면 제한된 대기 또는 주 DB 우회를 선택한다.
PostgreSQL의 Hot Standby에는 또 다른 운영 경계가 있다. 복제 적용과 충돌하는 장기 읽기 쿼리는 설정된 대기 시간을 넘으면 취소될 수 있다. 분석 쿼리를 복제본으로 옮겼다고 해서 주 DB의 쓰기와 독립된 것이 아니다. 최신 로그를 적용하려는 복구 프로세스와 오래 실행 중인 조회가 같은 자원을 두고 충돌한다. 따라서 복제본 전용 조회도 취소 오류를 재시도 가능한 것과 불가능한 것으로 구분하고, 재시도가 복제 지연을 더 키우는 악순환으로 변하지 않는지 확인해야 한다.
메커니즘을 이해했다면, 이제 “복제본을 더 썼으니 빨라졌다”는 인상 대신 실제 도입 판단에 필요한 관측 방법을 설계할 차례다. 평균 지연이 아니라 최신성 위반과 우회 비용을 함께 비교해야 한다.
3. ‘평균 지연은 낮은데 왜 주 DB가 먼저 무너질까?’ 복제 지연과 폴백의 동시 측정
읽기 복제본 도입 전후를 비교할 때 가장 위험한 표는 “복제본 QPS 증가”와 “평균 응답 시간 감소”만 적힌 표다. 평균은 지연이 긴 구간을 숨기고, 복제본 QPS는 가장 민감한 요청이 주 DB로 우회한 대가를 감추며, 지연의 단위가 초·LSN·트랜잭션 수 중 무엇인지에 따라 해석도 달라진다. 비교는 같은 트래픽 분포와 같은 쓰기 부하에서, 기준선과 정책 적용 후의 요청 결과를 나란히 놓아야 한다.
아래 수치는 특정 시스템의 성능을 주장하는 값이 아니다. 카나리에서 실측값을 채우기 위한 비교표와 통과 기준의 예시다. 기준을 채우지 못하면 더 많은 트래픽을 보내는 대신 계약 범위를 좁히거나 롤백한다.
| 측정 지표 | 기준선: 단순 복제본 라우팅 | 정책 적용 후 목표 | 함께 확인할 위험 신호 |
|---|---|---|---|
| 신선도 계약 위반율 | 실측: 최근 쓰기 뒤 오래된 응답 비율 | 중요 흐름에서 0건 | 오류가 아니라 정상 200 응답으로 기록되는 경우 |
| 복제본 지연 p95·p99 | 실측 분포 | 각 요청의 maxStaleness 이내 | 평균은 낮지만 스파이크가 길게 지속 |
| 주 DB 폴백율 | 정책 없음 | 사전 합의한 용량 예산 이내 | 지연 구간에서 주 DB CPU·커넥션 급등 |
| 대기 예산 초과율 | 측정하지 않음 | 요청별 대기 예산 안에서 종료 | 스레드·커넥션 점유가 큐잉 지연으로 전파 |
| 복제본 조회 취소율 | 실측 기준값 | 재시도 정책 안에서 안정화 | 재시도가 같은 복제본에 집중 |
계측에는 최소 네 종류의 식별자가 필요하다. 첫째, 쓰기 성공 시 기록한 버전 또는 커밋 위치다. 둘째, 복제본이 적용한 위치와 관측 시각이다. 셋째, 라우터가 복제본·대기·주 DB 중 무엇을 선택했는지다. 넷째, 실제 응답이 계약을 만족했는지다. 이 네 가지가 하나의 트레이스에 없으면 “복제 지연이 높아서 우회했다”와 “라우터의 건강 판정이 틀려서 우회했다”를 구분할 수 없다.
특히 복제본마다 지연이 다르다는 점을 놓치기 쉽다. 로드 밸런서는 커넥션 수나 CPU만 보고 가장 덜 바쁜 복제본을 고를 수 있지만, 그 노드가 가장 오래된 노드일 수 있다. 반대로 최신 복제본 하나에 read-your-writes 요청이 몰리면 그 노드의 큐가 늘어 최신성 이점이 사라진다. 후보 노드를 고를 때는 건강 상태, 적용 위치, 쿼리 대기열, 리전 거리, 요청의 신선도 예산을 함께 고려해야 한다. 하나의 전역 replica_lag 숫자로 라우팅하는 설계가 취약한 이유다.
부하 시험은 정상적인 일정 쓰기만으로 끝내지 않는다. 대량 배치, 인덱스 유지보수, 네트워크 지연, 복제본 재시작, 장기 분석 쿼리, 주 DB 장애 조치를 섞어야 한다. 그때에도 사용자별 최근 쓰기 읽기가 보장되는지, 폴백이 주 DB를 과부하로 몰지 않는지, 그리고 계약을 만족할 수 없을 때 제품이 어떻게 실패하는지를 확인한다. 성공 경로의 성능보다 실패 경로의 예측 가능성이 이 아키텍처의 실제 품질을 결정한다.
4. ‘모든 읽기를 주 DB로 돌리면 끝나지 않을까?’ 신선도 계약의 비용과 안티패턴
가장 흔한 임시 처방은 “쓰기 뒤 N초 동안 주 DB를 읽는다”이다. 이 방식은 구현이 간단하고 많은 제품에서 충분히 실용적이다. 다만 N초는 측정된 복제 분포나 사용자 흐름의 최신성 요구가 아니라 관성으로 정해지는 경우가 많다. 평상시 복제 지연이 매우 짧으면 주 DB 부하를 불필요하게 늘리고, 장애 중 지연이 N초를 넘으면 여전히 오래된 값을 읽는다. TTL 고정은 첫 단계의 안전장치로 쓸 수 있지만, 최종 계약으로 남겨 두면 지연의 원인을 가리고 용량을 낭비한다.
다른 극단은 모든 읽기에 커밋 위치 대기를 강제하는 것이다. 이 접근은 검색·피드·집계처럼 오래된 데이터가 허용되는 경로까지 복제 진행을 기다리게 해, 시스템 전체의 꼬리 지연을 올린다. AWS의 CQRS 가이드가 읽기와 쓰기를 분리하는 이유도 처리량·지연·일관성 요구가 다르기 때문이다. 읽기 모델을 쓴다면 그 모델이 어떤 요구에는 eventual consistency를 제공한다는 사실을 제품 인터페이스에 드러내야 한다.
💡 실무 원칙: 중요 흐름에는 read-your-writes를 적용하되, 폴백율·대기 시간·주 DB 커넥션을 같은 SLO로 관리하고 런타임 우회 스위치를 준비합니다.
또한 버전 토큰을 사용자 세션 전체에 영구히 붙이는 방식도 조심해야 한다. 한 번의 쓰기로 생성된 높은 요구 버전이 모든 이후 조회에 전파되면, 사용자는 한 화면에서만 최신성이 필요했는데도 긴 시간 주 DB 또는 특정 복제본에 고정된다. 반대로 버전을 전혀 전파하지 않으면 저장 직후의 읽기가 복제본으로 흩어져 간헐적 재현 오류가 된다. 안전한 기본값은 변경을 수행한 명령과 직접 이어지는 조회 체인에만 토큰을 전파하고, 만료·범위·업무 객체를 명확히 제한하는 것이다.
마지막으로 장애 조치에서는 복제 위치가 정상적으로 비교된다는 전제를 버려야 한다. 주 DB 승격·역할 전환·재동기화 중에는 이전의 위치 토큰이 새 토폴로지에서 해석되지 않을 수 있다. 이때 라우터는 “가장 최신 복제본”을 추측하지 말고, 쓰기·읽기 엔드포인트의 역할과 건강 상태가 확정될 때까지 계약이 강한 요청을 보수적으로 처리해야 한다. 위치 토큰의 비교 불능은 성능 경고가 아니라 정합성 모드 전환 신호다.
5. ‘두 번의 배포 안에 안전하게 도입하려면?’ 신선도 계약의 3단계 로드맵
| 단계 | 핵심 실행 과제 | 산출물 및 검증 지표 |
|---|---|---|
| Phase 1 | 모든 읽기 API를 최신성 요구로 분류한다. 최근 쓰기 보장, 제한된 stale 허용, 자유로운 eventual consistency의 세 등급으로 시작한다. | 요청별 maxStaleness·실패 정책 표, 복제 지연·주 DB 우회 기준선 |
| Phase 2 | 한 개의 중요하지만 가역적인 쓰기-읽기 흐름에 버전 전파와 제한된 폴백을 카나리 적용한다. 기존 TTL 고정과 정책 기반 라우팅을 같은 workload에서 비교한다. | 신선도 계약 위반 0건, 폴백율과 주 DB 용량 예산 준수 |
| Phase 3 | 복제본 지연·재시작·장기 조회·장애 조치를 주입하고, 대기 예산 초과와 위치 비교 불능에서의 런타임 전환을 검증한다. | 복구 절차, 요청별 실패 응답, 롤백 스위치와 운영 대시보드 |
읽기 복제본은 데이터를 한 군데 더 두는 기능이 아니라, 서로 다른 시간의 데이터를 어느 요청에 허용할지 결정하는 아키텍처다. 모든 요청에 하나의 정합성 규칙을 강요하면 시스템은 느려지거나 위험해진다. 반대로 최신성이 필요한 경로를 명시하고, 복제 진행 위치·대기 예산·주 DB 폴백을 함께 설계하면 읽기 확장성과 사용자 경험의 약속을 동시에 지킬 수 있다.
좋은 복제본 아키텍처는 지연을 없애겠다고 약속하지 않는다. 대신 어떤 요청이 언제까지의 데이터를 받아도 되는지, 그 약속을 지키지 못할 때 어떤 비용을 치를지를 숨기지 않는다.
공식 참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. PostgreSQL 공식 문서
이 글과 함께 읽으면 좋은 인사이트



댓글 0