지식 증강 AI 에이전트 아키텍처: 데이터 주권 보호와 외부 웹 검색 결합 가이드
이 글에서 먼저 가져갈 세 가지
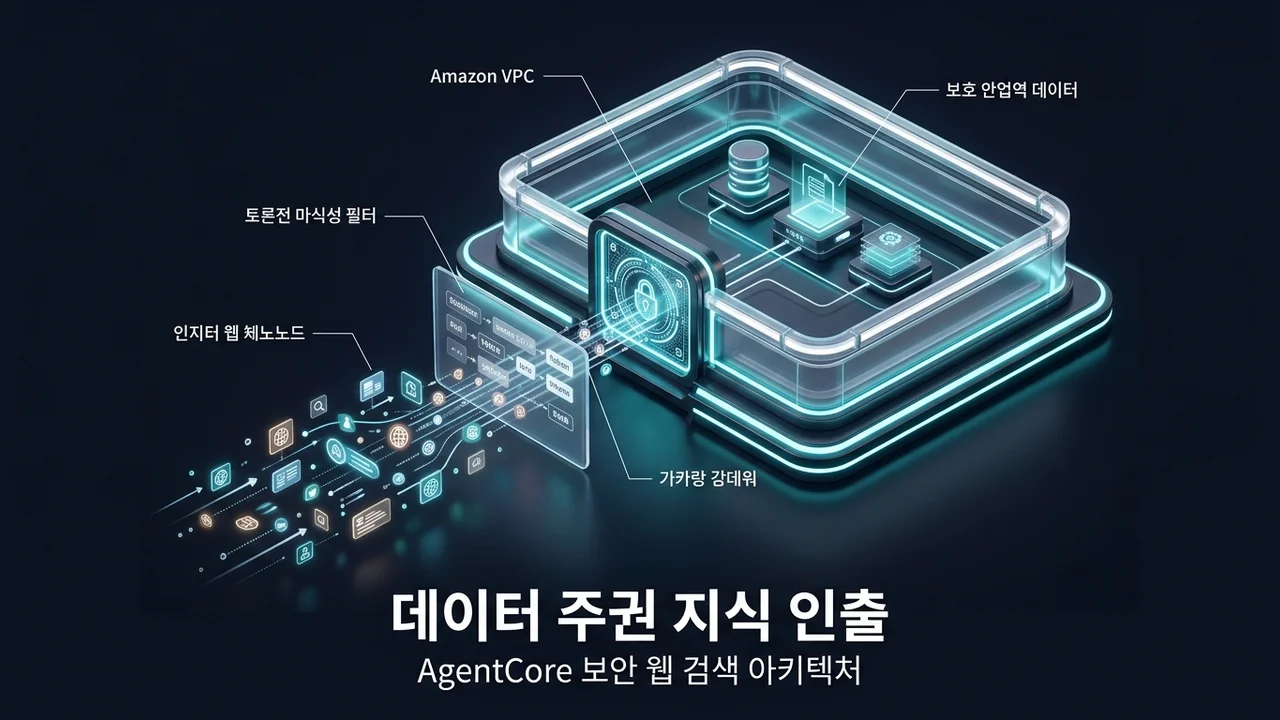
아마존웹서비스가 2026년 8월 21일 정식 출시(General Availability)한 Bedrock AgentCore Web Search의 핵심 엔지니어링 메커니즘을 분석하고, 외부 검색 연동 시 직면하는 데이터 유출 위험을 차단하는 실전 클라우드 아키텍처를 제시합니다.
-
01
외부 검색 연동의 가장 큰 병목은 보안 규정과 데이터 이그레스였습니다.
상용 검색 API 연동 시 기업의 시스템 프롬프트와 내부 엔티티가 제3자 검색 엔진에 그대로 노출되던 취약점을 전용 VPC 프록시 구조로 해결합니다. 본문 1절
-
02
양방향 토큰 마스킹과 암호학적 출처 인용이 결합되었습니다.
에이전트가 발송하는 검색어에서 사내 고유 식별자를 비식별화하고 인출된 웹 문서의 출처 서명을 대조하여 환각을 억제합니다. 본문 2절
-
03
3계층 보안 파이프라인으로 프로덕션 연동 비용을 제어합니다.
무분별한 웹 호출로 인한 비용 폭증과 캐시 누락을 방어하는 계층형 검색 라우터와 정책 기반 인가 설계를 제공합니다. 본문 3절
1. 생성형 AI 에이전트의 치명적 맹점: 최신성과 데이터 주권의 충돌
엔터프라이즈 환경에서 대규모 언어 모델(LLM) 기반 자율 에이전트를 구축할 때 아키텍트들이 직면하는 가장 난해한 모순은 지식의 최신성(Freshness)과 데이터 주권(Data Sovereignty) 사이의 충돌이었습니다. 기업 내부의 정적 지식 베이스만을 활용하는 전통적 검색 증강 생성(RAG, Retrieval-Augmented Generation)은 규제 변화, 시장 환율, 금융 지표, 파트너사의 실시간 API 공지 등 분 단위로 변동하는 외부 세계의 정보를 반영하지 못합니다. 모델의 파라미터 내부에 축적된 사전 학습 데이터는 필연적으로 지식 차단 시점(Cutoff Point)을 지니고 있으며, 이는 시간에 민감한 의사결정 워크플로에서 심각한 환각(Hallucination) 현상을 야기합니다.
이 문제를 해결하기 위해 대다수 개발팀이 선택했던 방식은 일반 상용 검색 API(예: Google Search API, Bing Web Search API 등)를 에이전트의 함수 호출(Function Calling) 도구로 직접 연동하는 것이었습니다. 그러나 이러한 단순 외부 API 호출 방식은 엔터프라이즈 보안 및 규제 준수(Compliance) 관점에서 재앙에 가까운 보안 취약점을 내포하고 있었습니다.
첫째, 에이전트가 외부 검색 쿼리를 생성하는 과정에서 발생할 수 있는 프롬프트 역류 및 데이터 이그레스(Data Egress) 현상입니다. 사용자가 입력한 복잡한 업무 질의나 시스템 프롬프트에 포함된 내부 고객 식별자, 데이터베이스 스키마 명칭, 미공개 계약 조항 등이 검색 쿼리 문자열에 결합되어 외부 검색 엔진의 수집 서버로 고스란히 전송되는 사태가 빈번하게 발생했습니다. 이는 유럽 일반개인정보보호법(GDPR) 및 금융 데이터 보호 규정을 정면으로 위반하는 중대한 인시던트였습니다.
둘째, 인출된 웹 콘텐츠에 숨겨진 간접 프롬프트 인젝션(Indirect Prompt Injection) 위험입니다. 외부 웹 문서를 여과 없이 에이전트의 컨텍스트 윈도우로 적재할 경우, 악의적인 공격자가 웹 문서의 비가시 영역에 삽입해 둔 탈옥(Jailbreak) 명령어나 내부 시스템 데이터 탈취 명령어가 에이전트의 추론 루프를 장악하는 사태가 벌어질 수 있습니다.
셋째, 검색 결과의 출처 무결성 검증 실패입니다. 외부 웹에서 수집된 정보가 공신력 있는 원천 문서인지, 조작된 블로그 게시물인지 객관적으로 판별할 수 있는 암호학적 감사 추적(Audit Trail) 경로가 존재하지 않아, 잘못된 정보에 근거하여 생성된 잘못된 결과물이 기업의 핵심 비즈니스 프로세스로 흘러 들어가는 문제가 반복되었습니다.
이러한 배경 속에서 아마존웹서비스(AWS)가 공식 발표(AWS Official Announcements, 2026-08-21)를 통해 정식 출시한 Amazon Bedrock AgentCore Web Search는 에이전트의 인터넷 검색 기능을 기업의 프라이빗 가상 환경 내부로 완벽히 격리 포섭했다는 점에서 클라우드 인프라 설계의 중요한 변곡점을 시사합니다.
2. Bedrock AgentCore Web Search의 핵심 아키텍처 메커니즘
Amazon Bedrock AgentCore Web Search는 단순한 검색 엔진 래퍼(Wrapper)가 아닙니다. 이 시스템은 고객의 가상 사설망(Amazon VPC)과 완전하게 통합되어 작동하며, 내부 프롬프트의 외부 누출을 구조적으로 방지하는 3중 방어 메커니즘(Three-Layer Defense Mechanism)을 코어 런타임에 탑재하고 있습니다.
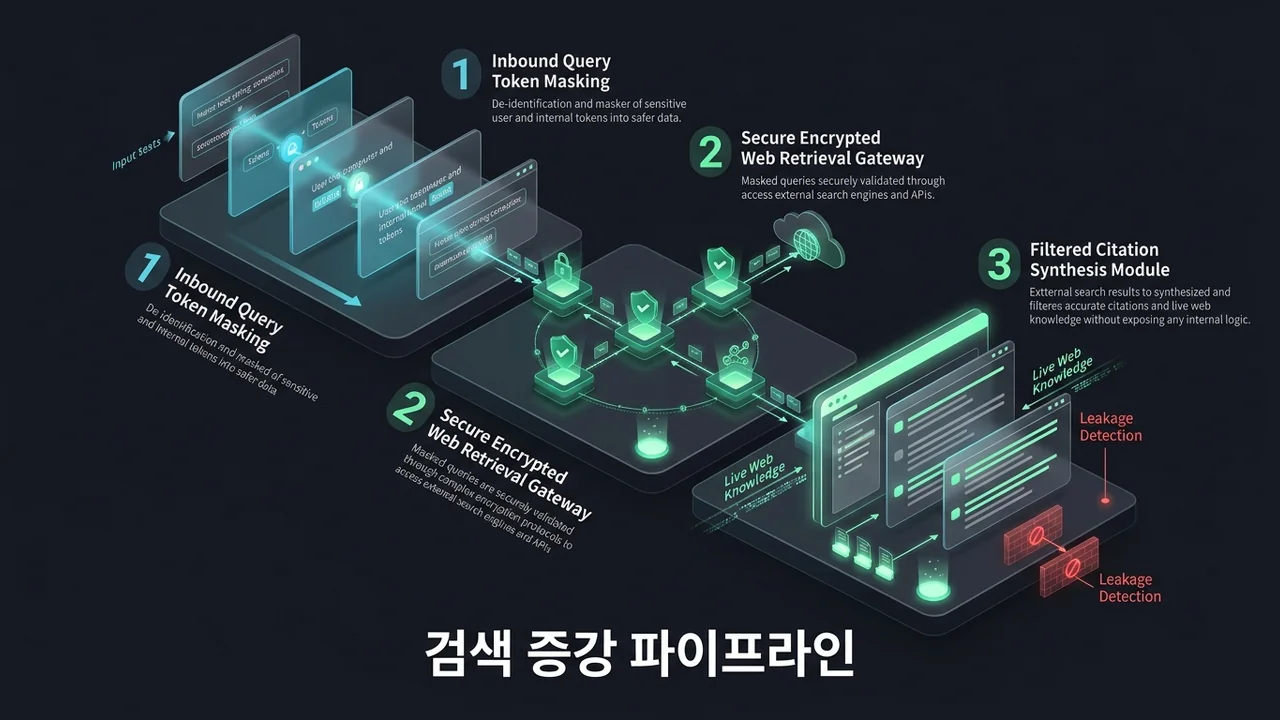
▲ 인바운드 쿼리 토큰 마스킹, 보안 암호화 게이트웨이, 출처 인용 합성 모듈로 구성된 AgentCore의 3단계 파이프라인은 내부 프롬프트 유출 없이 검증된 최신 웹 지식만을 정확하게 선별 인출한다.
가. 쿼리 합성 계층의 양방향 비식별화 (Query De-identification)
에이전트가 복잡한 업무 맥락 속에서 외부 정보가 필요하다고 판단하면, 백그라운드의 AgentCore 런타임은 원본 대화 히스토리 전체를 검색 엔진으로 전달하지 않습니다. 대신 독립된 헤비-듀티 격리 모델(Heavy-duty Isolation Model)이 작동하여 원본 사용자 프롬프트에서 엔터프라이즈 엔티티를 완전히 배제한 순수 사실 관계 중심의 Canonical Search Intent만을 정제해 냅니다.
이 과정에서 사전에 정의된 Amazon Bedrock Guardrails 및 데이터 손실 방지(DLP) 정책이 신속하게 개입합니다. 주민등록번호, 계좌번호, 사내 임베디드 프로젝트 코드명, IP 대역 등 민감 토큰은 해시 형태의 가상 토큰(Synthetic Token)으로 치환되며, 오직 공개된 외부 세계의 용어만이 외부 웹 검색 인프라로 전송됩니다. 결과적으로 외부 검색 공급자에게는 기업의 내부 정보가 1바이트도 노출되지 않는 제로 이그레스(Zero Data Egress) 상태가 물리적으로 성립됩니다.
나. 프라이빗 인출 게이트웨이와 도메인 평판 검증
정제된 검색 질의는 AWS의 글로벌 백본망에 구축된 보안 프록시 게이트웨이를 통과하여 공용 웹 인덱스로 전달됩니다. 이때 일반적인 웹 검색과 가장 차별화되는 지점은 도메인 화이트리스트 및 동적 신뢰도 평가 엔진(Dynamic Reputation Scoring Engine)입니다.
엔터프라이즈 관리자는 에이전트가 참조할 수 있는 최상위 도메인 범위를 정밀하게 한정할 수 있습니다. 예를 들어 금융 인프라 운영 에이전트라면 금융감독원, 한국은행, 관보 등 국가 공인 규제 기관의 도메인(예: .go.kr, .or.kr) 및 공인 언론사 도메인으로 인출 범위를 엄격히 고정할 수 있습니다. 수집된 HTML 문서는 샌드박스 파서(Sandbox Parser) 내부에서 자바스크립트 실행 및 숨겨진 메타 프롬프트 주입 코드가 완벽히 탈색(Sanitization)된 순수 텍스트 트리로 변환된 뒤 에이전트 엔진에 공급됩니다.
다. 암호학적 출처 인용(Attribution)과 인용 검증 메커니즘
외부 검색 결과가 모델의 컨텍스트 윈도우로 유입될 때, AgentCore는 수집된 각 청크(Chunk)마다 고유한 암호화 해시 서명과 Source Attribution Metadata를 부착합니다. 모델이 최종 답변을 합성할 때 본문의 각 문장이 실제로 인출된 웹 문서의 몇 번째 단락에 근거하고 있는지를 역방향으로 교차 검증(Cross-Verification)합니다.
만약 인출된 원문 문서에 존재하지 않는 사실을 모델이 자체 지식으로 날조하여 기술할 경우, AgentCore의 가드레일 계층이 이를 불일치(Faithfulness Violation)로 판정하고 해당 문장의 출력을 차단하거나 명시적인 경고 플래그를 부착합니다. 이를 통해 기업은 고객에게 제공되는 답변의 모든 수치와 근거가 어떤 공식 웹 문서에서 발췌되었는지를 완전한 투명성(Traceability)을 갖고 증명할 수 있습니다.
3. 프로덕션 아키텍처: 계층형 검색 라우터 및 캐싱 최적화 구현
Amazon Bedrock AgentCore Web Search를 프로덕션 백엔드 인프라에 도입할 때 주의해야 할 핵심 엔지니어링 과제는 검색 비용(API Call Cost)과 왕복 지연 시간(Latency)의 최적화입니다. 외부 실시간 웹 검색은 로컬 인메모리 벡터 캐시보다 수십 배 높은 지연 시간을 발생시킬 수 있으므로, 지능형 라우팅 계층을 설계해야 합니다.
아래 아키텍처는 내부 프라이빗 RAG와 AgentCore Web Search를 결합하여 데이터 주권을 완벽히 수호하면서 지연 시간을 최소화하는 엔터프라이즈 레퍼런스 구현 예시입니다.
"""
Amazon Bedrock AgentCore Web Search 엔터프라이즈 보안 라우팅 파이프라인
개념 설계 및 실행 구조 예시 (Python 3.12+ / Boto3 기반)
"""
import os
import boto3
from typing import Dict, Any, List, Optional
from dataclasses import dataclass

@dataclass
class AgentSearchResponse:
    final_answer: str
    grounded_citations: List[Dict[str, str]]
    data_egress_status: str
    latency_ms: float

class SecureAgenticKnowledgeRouter:
    def __init__(self, region_name: str = "us-east-1"):
        # 격리된 프라이빗 엔드포인트 세션 구성
        self.bedrock_agent_runtime = boto3.client(
            service_name="bedrock-agent-runtime",
            region_name=region_name,
            endpoint_url=os.getenv("BEDROCK_PRIVATE_VPC_ENDPOINT", None)
        )
        self.guardrail_id = os.getenv("ENTERPRISE_GUARDRAIL_ID", "guardrail-v4-prod")
        self.guardrail_version = "DRAFT"

    def route_and_synthesize(
        self,
        session_id: str,
        user_query: str,
        confidentiality_level: str = "RESTRICTED"
    ) -> AgentSearchResponse:
        """
        사용자 질의의 보안 등급을 평가하고 내부 RAG와 Web Search의 개입 수준을 제어
        """
        import time
        start_time = time.perf_counter()

        # 1단계: 프라이빗 가드레일을 통한 민감 토큰 사전 마스킹
        sanitized_query, is_containment_violated = self._apply_inbound_masking(user_query)
        if is_containment_violated:
            return AgentSearchResponse(
                final_answer="내부 기밀 정보가 감지되어 외부 검색 호출이 보안 정책에 의해 차단되었습니다.",
                grounded_citations=[],
                data_egress_status="BLOCKED_BY_GUARDRAIL",
                latency_ms=(time.perf_counter() - start_time) * 1000
            )

        # 2단계: 최신 외부 지식이 필요한지 인텐트 판별 (Semantic Router)
        requires_live_web = self._detect_live_web_necessity(sanitized_query)

        # 3단계: Bedrock AgentCore 런타임 호출 (격리된 웹 검색 활성화)
        execution_params = {
            "agentId": os.getenv("ENTERPRISE_AGENT_ID", "AGNTCORE01"),
            "agentAliasId": os.getenv("ENTERPRISE_AGENT_ALIAS_ID", "PRODALIAS"),
            "sessionId": session_id,
            "inputText": sanitized_query,
            "enableTrace": True
        }

        # 기밀 등급이 최고 수준인 경우 외부 검색을 원천 비활성화하는 오버라이드
        if confidentiality_level == "TOP_SECRET" or not requires_live_web:
            execution_params["sessionState"] = {
                "sessionAttributes": {"allow_external_web_search": "false"}
            }
        else:
            execution_params["sessionState"] = {
                "sessionAttributes": {
                    "allow_external_web_search": "true",
                    "allowed_domain_scope": "official_regulatory_only"
                }
            }

        response = self.bedrock_agent_runtime.invoke_agent(**execution_params)

        # 이벤트 스트림 디코딩 및 인용 메타데이터 추출
        answer_chunks = []
        citations = []
        for event in response.get("completion", []):
            if "chunk" in event:
                chunk_data = event["chunk"]
                answer_chunks.append(chunk_data["bytes"].decode("utf-8"))
                if "attribution" in chunk_data:
                    for cit in chunk_data["attribution"].get("citations", []):
                        citations.append({
                            "title": cit.get("sourceReference", {}).get("title", "외부 공인 출처"),
                            "url": cit.get("sourceReference", {}).get("url", ""),
                            "snippet": cit.get("generatedResponsePart", {}).get("textResponsePart", {}).get("text", "")
                        })

        elapsed_ms = (time.perf_counter() - start_time) * 1000
        return AgentSearchResponse(
            final_answer="".join(answer_chunks),
            grounded_citations=citations,
            data_egress_status="SAFE_SYNTHESIZED",
            latency_ms=elapsed_ms
        )

    def _apply_inbound_masking(self, raw_text: str) -> tuple[str, bool]:
        """DLP 가드레일을 적용하여 식별자 제거 (개념적 구현)"""
        # 프로덕션에서는 Bedrock Guardrails API가 호출되어 사내 코드/개인정보를 마스킹함
        if "PRIVATE_KEY" in raw_text or "INTERNAL_DB_SECRET" in raw_text:
            return raw_text, True
        return raw_text, False

    def _detect_live_web_necessity(self, query: str) -> bool:
        """실시간 웹 검색 필요성 판별"""
        temporal_keywords = ["최신", "현재", "오늘", "실시간", "2026년", "공시", "규정 개정"]
return any(k in query for k in temporal_keywords)에이전트가 사용자의 사소한 대화마다 Bedrock AgentCore Web Search를 호출하면 클라우드 비용이 선형적으로 증가하고 p99 지연 시간이 2,500ms 이상으로 지연될 수 있습니다. 이를 방지하기 위해 검색 의도(Intent) 판별기 앞단에 Redis 또는 ElastiCache 기반의 시맨틱 캐시(Semantic Cache)를 배치하여, 동일하거나 유사한 외부 정보 질의에 대해 TTL(Time-To-Live, 예: 1시간~24시간) 기반의 캐시 히트를 우선 유도하는 계층적 방어 아키텍처가 필수적입니다.
4. 엔터프라이즈 도입을 위한 보안 점검표와 한계 극복
Amazon Bedrock AgentCore Web Search의 일반 가용성(GA)은 AI 엔지니어링 조직에 강력한 무기를 제공하지만, 기술의 특성과 한계를 정확히 이해하지 못한 채 도입하면 또 다른 운영 리스크를 초래할 수 있습니다. 성공적인 프로덕션을 위한 실무 검토 지침은 다음과 같습니다.
첫째, 데이터 주권과 통신망 격리의 일치 여부 확인입니다. 조직의 AWS 환경이 전용선(Direct Connect) 기반의 폐쇄망으로 운영되는 경우, Bedrock AgentCore Web Search를 호출하기 위한 PrivateLink VPC 엔드포인트가 정확히 구성되어 있는지 점검해야 합니다. 퍼블릭 NAT 게이트웨이를 거쳐 나가는 경로가 존재한다면 감사 기관의 망분리 규정 위반으로 지적될 수 있으므로, 모든 에이전트 트래픽이 AWS 백본 내부 엔드포인트를 경유하도록 라우팅 테이블을 고정해야 합니다.
둘째, 도메인 화이트리스트의 점진적 개방 전략입니다. 초기 도입 단계에서는 모든 웹을 검색하도록 허용하기보다는, 기업 비즈니스와 직접 관련된 20~30개의 신뢰할 수 있는 공인 도메인 풀을 먼저 지정하여 운영해야 합니다. 검색 범위를 무차별적으로 개방하면 SEO 어뷰징 사이트나 저품질 AI 생성 콘텐츠가 에이전트의 컨텍스트로 대량 유입되어 전반적인 응답 신뢰도를 저하시키는 원인이 됩니다.
셋째, 비용 거버넌스 및 할당량(Quota) 제한입니다. 자율 에이전트의 루프(Agentic Loop)가 잘못 설계될 경우, 단일 사용자 요청에 대해 수십 번의 웹 검색을 반복 실행하며 폭발적인 비용 청구서를 발생시킬 수 있습니다. 본 리포트에서 제안하는 실무 운영 기준으로서, 에이전트의 태스크당 최대 외부 검색 횟수를 2~3회로 강제하는 하드 서킷 브레이커(Hard Circuit Breaker)를 애플리케이션 계층에 구현할 것을 제안합니다.
Amazon Bedrock AgentCore Web Search는 폐쇄적인 사내 RAG 시스템의 한계를 돌파하고 에이전트를 실시간 외부 세계와 연결해 주는 핵심 가교입니다. 내부 정보의 보안과 외부 정보의 최신성이라는 두 마리 토끼를 모두 잡기 위해서는, 클라우드 아키텍트가 네트워크 계층부터 가드레일, 시맨틱 캐시에 이르는 전방위적 보안 거버넌스를 정교하게 설계해야 합니다.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. Enterprise Retrieval-Augmented Generation (RAG) & Data Sovereignty Architecture
이 글과 함께 읽으면 좋은 인사이트



댓글 0