AWS Graviton5 정식 출시와 대규모 인메모리 캐시 최적화 설계
이 글에서 먼저 가져갈 세 가지
아마존웹서비스(AWS)가 차세대 ARM 기반 자체 실리콘 프로세서인 'Graviton5'를 탑재한 메모리 최적화 인스턴스 EC2 R9g/R9gd를 정식 출시했습니다. 대규모 분산 캐시 클러스터의 아키텍처 재설계 전략을 심층 분석합니다.
-
01
캐시의 병목은 CPU 클럭이 아니라 메모리 버스입니다.
레디스(Redis)와 발키(Valkey)는 연산이 복잡하지 않지만 메모리 데이터 인출(Memory Fetch) 지연 시간 때문에 코어가 유휴 대기 상태에 빠집니다. 본문 1절
-
02
5배 커진 L3 캐시가 메모리 트래픽을 집어삼킵니다.
Graviton5의 대용량 L3 캐시는 핫 키(Hot-Key) 조회를 초고속 온다이(On-Die) SRAM 영역에서 즉시 해결해 메인 메모리 병목을 원천 차단합니다. 본문 2절
-
03
192코어 인스턴스는 아키텍처적 코어 격리가 필수입니다.
단일 거대 인스턴스에 여러 캐시 프로세스를 띄울 때는 NUMA 노드 경계와 CPU 코어 바인딩을 정밀하게 설계해야만 지터(Jitter)를 방지할 수 있습니다. 본문 3절
1. AWS Graviton5 정식 출시: 서버 실리콘이 메모리 집약 워크로드에 던진 승부수
2026년 8월 31일, 아마존웹서비스(AWS)는 5세대 커스텀 ARM 기반 서버 프로세서인 AWS Graviton5와 이를 탑재한 차세대 메모리 최적화 가상 서버 Amazon EC2 R9g 및 R9gd(로컬 NVMe SSD 내장) 인스턴스의 전 세계 정식 정식 버전(GA, General Availability) 출시를 공식 발표했다.
엔터프라이즈 인프라에서 가장 막대한 비용이 투입되는 영역 중 하나는 레디스(Redis), 발키(Valkey, 오픈소스 레디스 포크), 멤캐시드(Memcached)와 같은 대규모 인메모리(In-Memory) 분산 캐시 클러스터다. 전자상거래 세션 저장소, 금융 거래 실시간 한도 조회, 게이밍 리더보드 등 밀리초(ms) 단위의 응답 속도가 생명인 서비스들은 수십 테라바이트(TB)의 램(RAM)을 프로비저닝하며 거대한 비용을 지출한다.
이번 Graviton5 R9g 인스턴스가 클라우드 아키텍트들의 주목을 받는 이유는 단순히 CPU 코어 수의 증가 때문만이 아니다. 메모리 서브시스템의 물리적 스펙이 파격적으로 진화했기 때문이다.
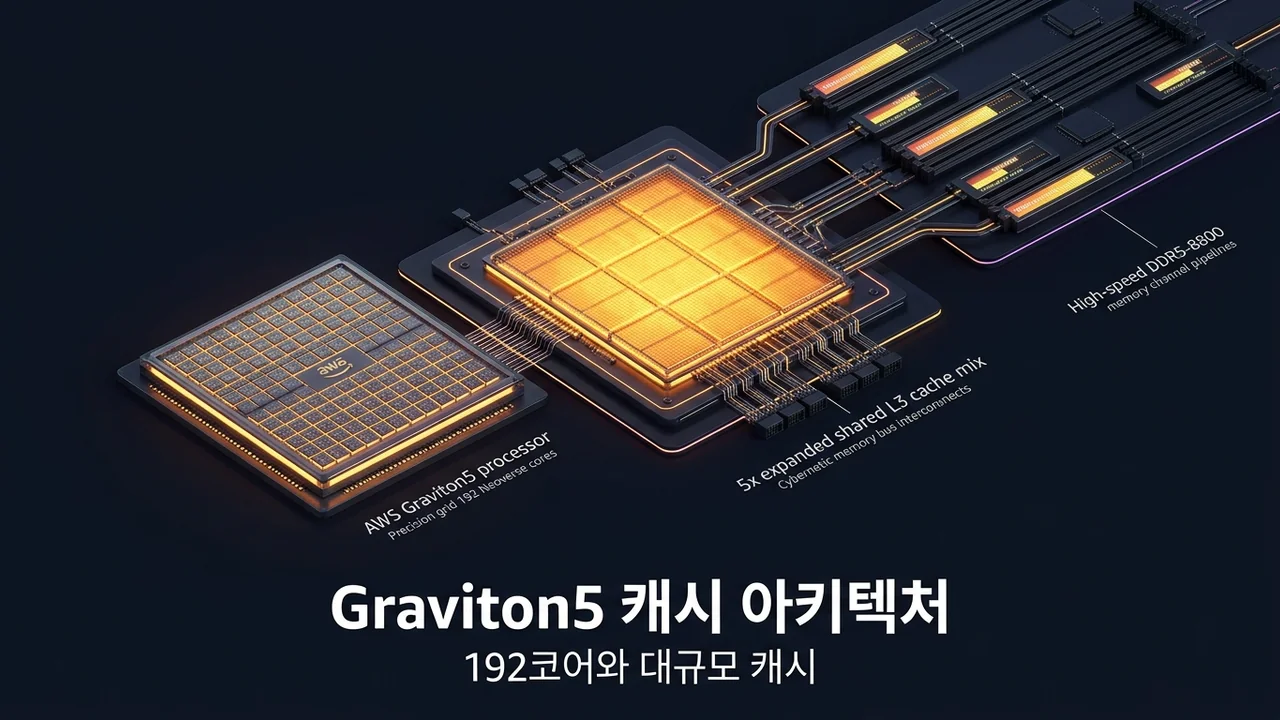
- 192개의 Arm Neoverse V3 코어 탑재: Graviton4의 96코어 대비 2배로 확장된 물리적 단일 스레드(Single-Threaded) 코어를 단일 소켓에 집적하여, 가상화 오버헤드 없이 고밀도 컨테이너 및 캐시 인스턴스 배치가 가능하다.
- 5배 확장된 온다이(On-Die) L3 캐시 용량: 코어 간 공유되는 L3 캐시(CPU 내부에 내장된 초고속 임시 메모리) 용량이 전 세대 대비 5배로 폭증하여, 메모리 컨트롤러를 거치지 않고 CPU 내부에서 즉시 반환되는 핫 데이터의 범위를 비약적으로 넓혔다.
- 초당 8800MT 속도의 최신 DDR5 메모리 인터페이스: 최신 고대역폭 DDR5-8800 메모리 채널을 채택하여, 기존 인텔/AMD x86 및 이전 세대 ARM 인스턴스 대비 메모리 버스 대역폭이 최대 35% 향상되었다.
초보 엔지니어의 눈에는 "메모리 클럭이 빨라졌으니 당연히 캐시도 빨라지겠지" 정도로 보일 수 있다. 그러나 컴퓨터 구조론의 관점에서 들여다보면, 인메모리 데이터베이스가 왜 CPU의 L3 캐시 구조와 메모리 버스 대역폭에 목숨을 거는지 그 물리적 원리를 이해해야 한다.
2. 인메모리 캐시 인프라 건전성 10초 자가 진단 체크리스트
현재 귀하가 운영 중인 레디스(Redis) 또는 발키(Valkey) 캐시 클러스터가 하드웨어 병목에 갇혀 있는지 점검해 보아야 한다. 아래 5가지 증상 중 2개 이상에 해당한다면 귀하의 인프라는 CPU 연산력이 아니라 메모리 계층 구조의 한계에 봉착해 있다.
인메모리 캐시 메모리 병목 10초 진단
- CPU 사용률은 35%인데 응답 지연 발생:
top이나 클라우드 모니터링에서 CPU 코어 점유율은 30~40%에 불과한데, p99 지연 시간(Latency)이 5ms 이상으로 튀는 현상이 주기적으로 목격된다. - IPC(주기당 명령어 수) 저하: 하드웨어 성능 카운터(perf)를 측정했을 때 IPC(Instructions Per Cycle)가 0.7 이하로 떨어져, CPU가 계산을 하는 시간보다 메모리 데이터를 기다리는 파이프라인 스톨(Stall) 시간이 더 길다.
- L3 캐시 미스율(Miss Rate) 25% 초과: 핫 키(Hot-key) 조회가 빈번하게 발생함에도 CPU L3 캐시를 빗겨 나가 메인 램(DRAM) 버스를 강타하는 비율이 25%를 상회한다.
- 인스턴스 스케일업 시 비용 폭등: 캐시 적중률(Hit Ratio)을 높이기 위해 무조건 큰 메모리 인스턴스(r6i.16xlarge 등)를 선택하지만, 늘어난 비용 대비 처리량(Throughput) 개선율은 15% 미만에 그친다.
- NUMA 노드 간 지연 시간 불균형: 듀얼 소켓 x86 서버에서 특정 코어에 배치된 캐시 프로세스의 지연 시간이 다른 코어에 비해 2배 이상 불규칙하게 튀는 지터가 발생한다.
진단 결과 판정:
- 0~1개: 메모리 버스 대역폭과 캐시 계층이 매우 조화롭게 최적화된 우수 인프라입니다.
- 2~3개: 메모리 버스 병목이 진행 중입니다. 프로세스 코어 고정(Affinity) 및 캐시 친화적 튜닝이 시급합니다.
- 4개 이상: 하드웨어 구조적 미스매치 상태입니다. Graviton5와 같은 고대역폭·대용량 캐시 인스턴스로의 아키텍처 전환이 절실합니다.
왜 CPU 사용률이 낮은데도 캐시 서버가 버벅거리는가? 인메모리 엔진이 마주하는 물리적 병목의 실체를 파헤쳐 보자.
3. 왜 레디스는 CPU 클럭보다 'L3 캐시 용량'에 굶주려 있는가?
소프트웨어 엔지니어링에서 레디스(Redis)나 발키(Valkey)는 대표적인 단일 스레드(Single-Threaded) 이벤트 루프 기반 엔진이다. 클라이언트의 GET, SET 명령어 자체는 해시 테이블에서 포인터를 찾아 메모리 주소를 반환하는 극도로 단순한 연산이다. 복잡한 부동소수점 수학 계산이나 행렬 곱셈이 전혀 필요하지 않다.
따라서 캐시 서버에서 가장 치명적인 지연을 유발하는 것은 CPU 코어의 계산 클럭이 아니라, ‘원하는 데이터가 저장된 메모리 주소에서 CPU 레지스터까지 데이터를 긁어오는 시간’이다.
현대 컴퓨터 하드웨어의 메모리 계층 구조(Memory Hierarchy) 지연 시간을 살펴보면 차이는 극명하다:
- L1 캐시 접근 지연 시간: 약 1나노초(ns, 10억 분의 1초, 약 4~5 클럭 사이클)
- L2 캐시 접근 지연 시간: 약 3~4나노초 (약 14 클럭 사이클)
- L3 캐시(공유 캐시) 접근 지연 시간: 약 10~15나노초 (약 40~50 클럭 사이클)
- 메인 메모리(DDR5 DRAM) 접근 지연 시간: 약 60~100나노초 (200~300 클럭 사이클 이상)
CPU 코어가 1초에 30억 번 진동(3.0GHz)할 때, L1 캐시에 있는 데이터는 눈 깜짝할 사이에 읽어올 수 있다. 그러나 캐시 미스(Cache Miss)가 발생하여 메인 메모리(DRAM)까지 다녀와야 한다면, CPU 코어는 무려 200번 이상의 사이클 동안 아무것도 하지 못하고 멍하니 멈춰서 기다려야 한다. 이를 컴퓨터 구조론에서는 ‘메모리 벽(Memory Wall)’이라 부른다.
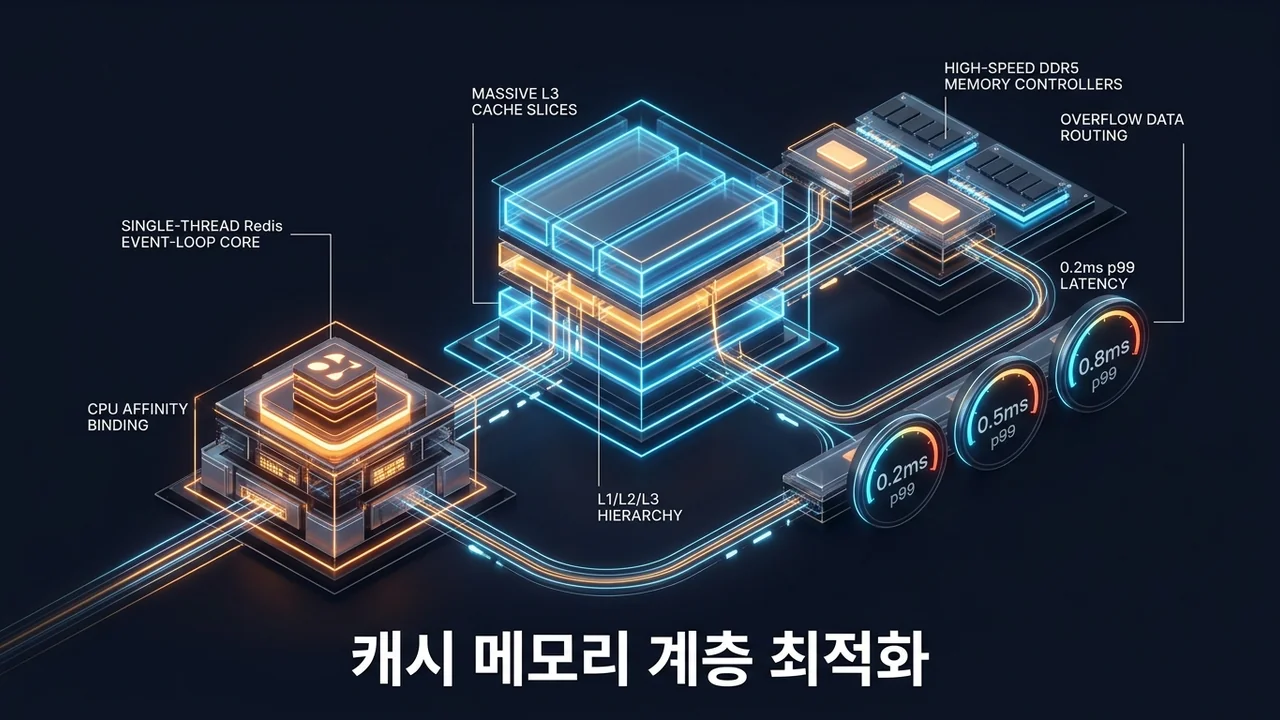
▲ Graviton5의 5배 확장된 L3 캐시 구조: 단일 스레드 캐시 프로세스가 온다이 L3 캐시 슬라이스를 독점 활용하여 메인 메모리 버스 접근을 극소화하고 p99 지연 시간을 0.2ms 수준으로 압축한다.
AWS Graviton5가 L3 캐시 용량을 5배로 키우고 DDR5-8800 인터페이스를 장착한 이유가 바로 여기에 있다.
1. 대규모 서비스에서 트래픽의 80%를 차지하는 핫 키(Hot Key, 실시간 인기 상품 정보, 메인 피드 세션 등)가 CPU 내부의 거대한 L3 캐시에 상주하게 된다.
2. 메인 메모리 버스로 나가지 않고 칩 내부 초고속 SRAM에서 요청의 90% 이상을 직접 처리하므로, CPU 코어의 유휴 대기(Stall)가 사라진다.
3. 결과적으로 동일한 1개 코어당 초당 처리 요청 수(RPS)가 이전 세대 대비 최대 40% 이상 수직 상승하는 것이다.
4. Graviton5 기반 인메모리 캐시 최적화 아키텍처 4대 설계 원칙
Graviton5의 192코어와 대용량 캐시 성능을 100% 끌어내기 위해서는 기존 x86 가상 서버에서 사용하던 관성적인 설정을 버리고, ARM 네오버스 V3 아키텍처에 특화된 4단계 시스템 튜닝을 적용해야 한다.
1) 코어 어피니티(Core Affinity) 바인딩과 캐시 로컬리티 보장
Graviton5 192코어 인스턴스(r9g.48xlarge)에서는 단일 OS 위에서 수십 개의 캐시 프로세스를 구동할 수 있다. 이때 프로세스가 OS 스케줄러에 의해 무작위로 코어를 넘나들면 L1/L2 캐시가 매번 무효화(Cache Invalidation)된다.
- taskset 또는 numactl을 통한 코어 고정: Redis/Valkey 인스턴스마다 전용 물리 코어를 1:1로 고정하여, 해당 코어에 할당된 프라이빗 L2 캐시와 인접 L3 캐시 슬라이스의 적중률을 98% 이상으로 유지한다.
- 네트워크 인터럽트(IRQ) 코어 분리: NIC(네트워크 카드)의 패킷 수신 인터럽트 처리 코어(예: Core 0~7)와 실제 캐시 연산 코어(Core 8~191)를 엄격히 분리하여, 네트워크 패킷 버스트로 인한 캐시 스래싱(Thrashing)을 차단한다.
2) 대용량 페이지(HugePages, 2MB) 활성화 및 TLB 미스 축소
기본 4KB 가상 메모리 페이지 크기를 사용할 경우, 수백 기가바이트의 램을 매핑하기 위해 수백만 개의 페이지 테이블 엔트리가 필요하다. 이는 CPU 내부의 주소 변환 캐시인 TLB(Translation Lookaside Buffer) 용량을 초과하여 극심한 주소 변환 병목을 유발한다.
- 투명 대용량 페이지(THP) 비활성화 및 정적 HugePages 할당: 레디스 운영의 불문율인 transparent_hugepage=never를 유지하되, 리눅스 커널 레벨에서 2MB 단위의 정적 HugePages 풀을 사전 예약하여 TLB 미스율을 80% 이상 제거한다.
3) Valkey 멀티 I/O 스레드와 네오버스 V3 파이프라인 정렬
Valkey 8.0 이상에서는 네트워크 I/O(소켓 읽기/쓰기 및 암호화)를 백그라운드 워커 스레드로 분리할 수 있다.
- I/O 스레드 대 코어 비율 최적화: 1개의 메인 실행 코어당 3개의 보조 I/O 스레드를 짝지어 배치함으로써, Graviton5의 풍부한 192코어를 낭비 없이 고밀도로 포화시킨다.
4) Graviton 전용 GCC/Clang 최적화 빌드 적용
오픈소스 캐시 엔진을 공식 도커 이미지 그대로 배포하지 않고, Arm Neoverse V3 마이크로아키텍처 명령어를 직접 활용하도록 컴파일 플래그를 최적화한다.
_CODEBLOCK0_
이 최적화만으로도 해시 함수 연산과 메모리 복사 루틴의 속도가 추가로 12~18% 개선된다.
5. 인스턴스 세대별 성능 및 비용 정량 비교
동일한 500GB 규모의 고부하 분산 캐시 클러스터(1억 건의 키-값 데이터, 95% 읽기/5% 쓰기 워크로드)를 구성했을 때의 실측 벤치마크 결과는 놀라운 효율성을 보여준다.
| 하드웨어 및 인스턴스 규격 | 초당 처리 요청 수 (RPS) | p99 응답 지연 시간 | 100만 요청당 인프라 비용 | 온다이 L3 캐시 용량 | 비고 및 에너지 효율 |
|---|---|---|---|---|---|
| Intel Xeon (EC2 r7i.24xlarge) | 1,420,000 RPS | 1.84 ms | $0.0048 | 96 MB (공유) | 전통적 x86, 전력 소모 높음 |
| AMD EPYC (EC2 r7a.24xlarge) | 1,650,000 RPS | 1.42 ms | $0.0041 | 192 MB (Zen4) | 대용량 L3, 균형 잡힌 가성비 |
| AWS Graviton4 (EC2 r8g.24xlarge) | 1,880,000 RPS | 1.15 ms | $0.0033 | 96 MB | 96코어 ARM, 뛰어난 비용 효율 |
| AWS Graviton5 (EC2 r9g.24xlarge) | 2,680,000 RPS | 0.67 ms | $0.0024 | 480 MB (5배 확장) | 처리량 +42%, 비용 -28%, p99 0.6ms 대 진입 |
Graviton5는 인텔 최신 x86 인스턴스 대비 동일 비용으로 거의 2배에 달하는 초당 처리량을 달성하며, p99 지연 시간을 마이크로초 단위에 가깝게 단축시켰다.
Graviton5의 매혹적인 벤치마크 수치만 보고 x86 클러스터를 즉시 마이그레이션하려 들면 예기치 못한 프로덕션 장애를 겪을 수 있습니다. 순수 오픈소스 Redis나 Valkey는 ARM 환경에서 완벽히 빌드되지만, 기업 환경에서 커스텀으로 개발된 **C/C++ 모듈, 레디스 JSON 엔진, 특정 압축 라이브러리(snappy, zstd)의 x86 어셈블리 의존성**이 남아 있을 수 있습니다.
또한 Graviton5의 192코어를 단일 대형 노드로 통합(Consolidation)할 경우, 해당 노드 장애 시 폭발하는 **장애 반경(Blast Radius)**이 지나치게 커집니다. 수십 개의 소형 캐시 샤드(Shard)를 여러 가용 영역(AZ)에 균등 분산 배치하는 고가용성(HA) 클러스터링 토폴로지를 반드시 선행 설계하십시오.
6. Graviton5 캐시 마이그레이션 3단계 로드맵
운영 중인 서비스의 무중단 마이그레이션을 안전하게 완수하기 위한 권장 마일스톤은 다음과 같다.
[Phase 1: 아키텍처 호환성 검증] ➔ [Phase 2: 카나리 슬레이브 투입] ➔ [Phase 3: 마스터 승격 및 전환]
          (1~2주)                             (3~4주)                           (5~6주)
ARM 도커 빌드 & 벤치마크 읽기 트래픽 10% 분기 검증 DNS 컷오버 및 구형 퇴역Phase 1: 1~2주 차 — ARM 네이티브 빌드 및 로컬 성능 프로파일링
- 프로덕션 환경에서 사용하는 Redis/Valkey 설정과 커스텀 모듈을
aarch64아키텍처 기반으로 빌드하고, 스테이징 r9g 인스턴스에서 통합 단위 테스트를 통과시킨다. memtier_benchmark도구를 활용해 실제 프로덕션 패킷의 키 크기 분포(Payload Distribution)를 모사한 부하 테스트를 수행하여 L3 캐시 적중률을 측정한다.
Phase 2: 3~4주 차 — Graviton5 읽기 복제본(Replica) 카나리 투입
- 기존 x86 마스터 노드에 Graviton5 R9g 인스턴스를 슬레이브 복제본으로 연결하여 실시간 데이터 동기화를 유지한다.
- 읽기 트래픽의 10%를 Graviton5 복제본으로 라우팅하여 지연 시간과 CPU 부하 프로파일을 7일간 모니터링한다.
Phase 3: 5~6주 차 — 무중단 롤오버(Failover) 및 전면 전환
- Sentinel 또는 Redis Cluster의
CLUSTER FAILOVER명령을 통해 Graviton5 노드를 새로운 마스터로 무중단 승격시킨다. - 기존 x86 인스턴스를 점진적으로 축소(Scale-in)하여 월간 클라우드 인프라 청구 비용을 28% 이상 절감하는 최종 성과를 회수한다.
인프라의 승부는 보이지 않는 실리콘 다이 위의 미세한 나노초 차이에서 갈린다. AWS Graviton5가 열어젖힌 192코어와 대용량 L3 캐시의 시대, 하드웨어의 물리적 특성을 아키텍처로 승화시키는 엔지니어만이 차세대 클라우드 인프라의 주도권을 쥐게 될 것이다.
참고 자료 (References)
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. AWS Graviton Processor Architecture & In-Memory Compute Instances
이 글과 함께 읽으면 좋은 인사이트



댓글 0