Anthropic Claude Prompt Caching: 멀티턴 에이전트의 캐시 친화적 프롬프트 계층화 및 FinOps 설계
이 글에서 먼저 가져갈 세 가지
자율 AI 에이전트가 수십 차례의 도구 호출과 멀티턴 추론 루프를 반복하면서 발생하는 기하급수적인 토큰 청구서 폭탄과 TTFT 지연 병목을 돌파하기 위해, Anthropic이 정식 도입한 Prompt Caching의 기술적 메커니즘과 캐시 친화적 프롬프트 계층화 설계 표준을 규명합니다.
-
01
5분 슬라이딩 TTL과 90% 비용 절감 메커니즘
최소 1,024 토큰(Claude 3.5 Sonnet) 이상의 정적 컨텍스트를 캐시로 잠금으로써, 매 호출 시 캐시 쓰기(25% 할증) 대비 압도적인 캐시 읽기(90% 할인) 혜택을 누리고 첫 토큰 응답 지연(TTFT)을 최대 85%까지 단축합니다. 본문 1·2절
-
02
4단계 프롬프트 계층화와 브레이크포인트 배치
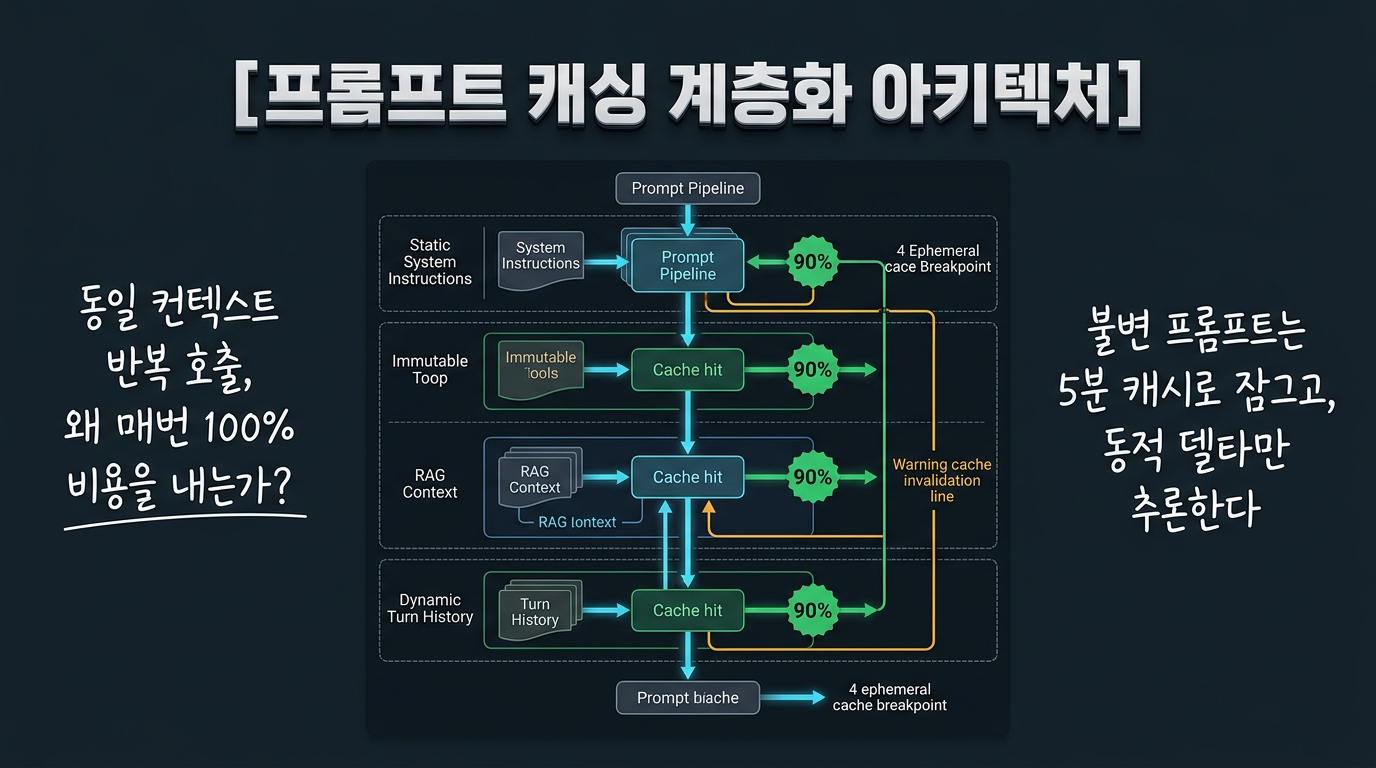
단 한 글자의 변경도 하위 캐시 전체를 무효화하는 전치사적 캐시 특성을 방어하기 위해 '불변 지침 → 도구 스키마 → RAG 코퍼스 → 동적 대화 턴' 순으로 배치하고 최대 4개의 ephemeral 마커를 전략적으로 분배합니다. 본문 3절
-
03
FinOps 거버넌스와 킵얼라이브 가드레일
동적 타임스탬프가 최상단에 주입되는 캐시 브레이킹 사고를 린트 단계에서 차단하고, 긴 도구 실행 중 경량 핑을 발송하여 5분 만료 윈도우를 지능적으로 연장하는 프로덕션 운영 아키텍처를 구축합니다. 본문 4·5절
1. 멀티턴 자율 에이전트의 컨텍스트 팽창과 FinOps 병목
엔터프라이즈 환경에서 자율 AI 에이전트(Autonomous AI Agent)가 프로덕션 시스템과 결합될 때 마주하는 가장 잔혹한 현실은 '컨텍스트 윈도우 팽창에 따른 기하급수적 인프라 비용 폭증'입니다. ReAct(Reasoning + Acting) 패턴이나 Plan-and-Solve 아키텍처를 기반으로 동작하는 에이전트는 하나의 복합 목표를 완수하기 위해 수십 개의 내부 API 도구 명세(Tools Schema), 방대한 기업 보안 가이드라인, 그리고 이전 턴들에서 수집한 관측 데이터(Observation History)를 매 요청마다 통째로 모델에 주입해야 합니다.
가령 50개의 마이크로서비스 도구 명세(약 12,000 토큰)와 전사 보안 통제 프롬프트(약 4,000 토큰), 그리고 사내 지식 베이스 청크(약 8,000 토큰)를 사용하는 에이전트가 존재한다고 가정해 보겠습니다. 이 에이전트가 사용자 질의를 해결하기 위해 15회의 도구 호출(15턴)을 수행한다면, 매 턴마다 최소 24,000 토큰에 달하는 동일한 기반 지침이 중복 전송됩니다.
[전통적인 Stateless LLM 호출 루프의 토큰 누적 비용]
Turn 1: [기반 지침 24k] + [사용자 질문 1k]                     = 25,000 Tokens 과금
Turn 2: [기반 지침 24k] + [사용자 질문 1k] + [도구 결과 2k]     = 27,000 Tokens 과금
Turn 3: [기반 지침 24k] + [히스토리 3k]   + [추가 도구 결과 2k] = 29,000 Tokens 과금
...
Turn 15: [기반 지침 24k] + [누적 히스토리 30k]                 = 54,000 Tokens 과금
---------------------------------------------------------------------------------
총 15턴 누적 입력 토큰: 약 580,000 Tokens 청구 (동일한 24k 지침만 360,000 토큰 중복 과금!)이러한 구조적 낭비는 두 가지 치명적인 병목을 유발합니다. 첫째, FinOps 재무 예측 불가능성입니다. 에이전트의 루프가 길어질수록 입력 토큰 청구액이 선형이 아닌 2차 함수 형태로 급증하여 단일 사용자 세션에서 수 달러의 비용이 순식간에 소진됩니다. 둘째, 첫 토큰 생성 지연(TTFT, Time-To-First-Token)의 악화입니다. 모델 가속기(GPU/TPU)는 매 요청마다 수만 토큰에 달하는 어텐션(Attention) Key-Value 행렬을 처음부터 다시 연산(Prefill Phase)해야 하므로, 에이전트의 각 추론 턴 사이에 3~6초 이상의 침묵이 발생하여 실시간 인터랙션 품질이 붕괴합니다.
Anthropic은 이 근본적인 병목을 정면으로 타파하기 위해 Anthropic Prompt Caching 공식 엔지니어링 스펙을 정식 발표하고, Claude 3.5 Sonnet 및 Claude 3 Haiku 제품군에 완전 관리형 프롬프트 캐싱을 지원하기 시작했습니다. 이 기술은 모델이 이미 연산한 거대 프롬프트 접두부의 KV 활성화 상태를 서버 측 메모리에 안전하게 보존하여, 재요청 시 입력 토큰 비용 90% 감면과 지연 시간 최대 85% 단축이라는 전례 없는 엔지니어링 도약을 제공합니다.
2. Anthropic Prompt Caching의 내부 작동 메커니즘과 5분 슬라이딩 TTL
Anthropic의 프롬프트 캐싱은 단순한 문자열 해시 기반의 응답 캐시(Response Semantic Cache)가 아닙니다. 트랜스포머 아키텍처의 인퍼런스 엔진 내부에서 실행되는 'KV(Key-Value) 활성화 텐서 수준의 메모리 체크포인팅' 기술입니다.
+-------------------------------------------------------------------------------+
|                 Anthropic Claude Prompt Caching 실행 아키텍처                 |
+-------------------------------------------------------------------------------+
[클라이언트 요청 파이프라인]
       │
       ▼
 ┌──────────────────────────┐      캐시 브레이크포인트      ┌──────────────────────────┐
 │ 1. 불변 시스템 프롬프트   │ ─── [type: ephemeral] ───► │ KV Cache Store (GPU Mem) │
 └──────────────────────────┘                              └─────────────┬────────────┘
       │                                                                 │
       ▼                                                          Cache HIT (90% OFF)
 ┌──────────────────────────┐      캐시 브레이크포인트                   │  Latency -85%
 │ 2. 고정 도구 명세 (Tools) │ ─── [type: ephemeral] ────────────────────┤
 └──────────────────────────┘                                            ▼
       │                                                   ┌──────────────────────────┐
       ▼                                                   │ Claude 3.5 Sonnet Engine │
 ┌──────────────────────────┐                              │ (신규 델타 토큰만 연산)   │
 │ 3. 동적 사용자 대화 턴    │ ─────────────────────────────► │ (Standard Input 과금)    │
 └──────────────────────────┘                              └─────────────┬────────────┘
                                                                         │
                                                                         ▼
[스트리밍 출력 및 5분 연장]2.1. 최소 토큰 조건과 브레이크포인트(ephemeral) 명세
Anthropic 엔진은 무분별한 캐시 단편화와 메모리 낭비를 방지하기 위해 명확한 최소 토큰 임계치 규칙을 강제합니다.
- Claude 3.5 Sonnet: 캐시 시작 지점까지의 누적 접두부 토큰이 최소 1,024 토큰 이상이어야 캐시가 활성화됩니다.
- Claude 3 Haiku: 캐시 시작 지점까지의 누적 접두부 토큰이 최소 2,048 토큰 이상이어야 합니다.
- 브레이크포인트 제한: 단일 API 요청 내에서 {"type": "ephemeral"} 제어 마커를 최대 4개까지 선언할 수 있습니다.
개발자는 시스템 메시지(system), 도구 정의(tools), 또는 대화 메시지 블록(messages) 내부의 임의 텍스트 청크 뒤에 cache_control: {"type": "ephemeral"}을 부여할 수 있습니다. 모델은 이 마커가 지정된 지점까지의 전체 텍스트를 정확히 1 토큰 단위의 바이트 레벨로 해싱하여 전용 KV 캐시 스토어에 보존합니다.
2.2. 5분 슬라이딩 TTL(Time-To-Live)의 라이프사이클
캐시의 기본 수명은 5분(300초)입니다. 중요한 점은 이 수명이 고정 윈도우가 아닌 '슬라이딩 윈도우(Sliding Window)'로 동작한다는 사실입니다.
1. Cache Write (첫 요청): 캐시가 존재하지 않을 때 브레이크포인트가 요청되면, 모델은 해당 블록을 메모리에 기록하고 5분의 TTL 타이머를 가동합니다. 이때는 기본 입력 토큰 단가 대비 25%의 일회성 할증 요금이 부과됩니다.
2. Cache Read (적중 요청): 첫 요청 이후 5분 이내에 동일한 접두부를 가진 후속 요청이 도착하면, 모델은 연산 없이 KV 메모리에서 즉시 복원합니다. 이때 해당 캐시 블록은 기본 단가 대비 90% 할인된 10%의 비용만 청구됩니다.
3. 자동 수명 연장(Sliding Reset): 캐시 적중(Cache Hit)이 발생할 때마다, 해당 캐시 엔트리의 5분 TTL 타이머는 0초로 리셋되어 다시 5분간 연장됩니다. 따라서 4분 50초 간격으로 지속적인 멀티턴 상호작용이 일어난다면 세션은 수 시간 동안 캐시 할인 혜택을 끊김 없이 유지할 수 있습니다.
| 과금 항목 (Claude 3.5 Sonnet 기준) | 백만 토큰(MTok)당 단가 | 기준 단가 대비 비율 | 비고 |
|---|---|---|---|
| 기본 입력 토큰 (Standard Input) | $3.00 | 100% | 캐시 미사용 일반 요청 |
| 캐시 생성/기록 (Cache Write) | $3.75 | 125% | 첫 턴 또는 만료 후 재기록 (+25%) |
| 캐시 읽기 적중 (Cache Read Hit) | $0.30 | 10% | 동일 접두부 재사용 (상당 수준 절감) |
| 출력 토큰 (Output) | $15.00 | - | 생성 토큰 단가 (불변) |
3. 캐시 친화적 프롬프트 계층화 설계 (Tiered Prompt Architecture)
Anthropic 프롬프트 캐싱의 가장 치명적인 제약이자 모든 플랫폼 엔지니어가 우선적으로 숙지해야 할 메커니즘은 '엄격한 전치사 일치(Strict Prefix Matching)' 원칙입니다. 트랜스포머의 어텐션 메커니즘은 이전 토큰들의 위치 인코딩과 인과적 마스킹(Causal Masking)에 종속되므로, 프롬프트의 시작 부분부터 1바이트라도 변경되면 그 뒤에 배치된 모든 캐시 엔트리는 무효화(Invalidated)됩니다.
프롬프트 최상단에 현재 시각(Current Time: 2026-09-11 14:20:00)이나 세션 고유 ID, 동적 사용자 프로필을 주입하는 전형적인 실수는 뒤따라오는 수만 토큰의 도구 명세와 RAG 문서 캐시 전체를 매 초마다 무력화하여 매 턴 125%의 쓰기 할증료를 발생시키는 재앙을 초래합니다.
따라서 엔지니어링 팀은 프롬프트 블록을 데이터의 '변경 주기(Volatility)'에 따라 정밀하게 계층화해야 합니다.
[캐시 친화적 프롬프트의 4계층 물리적 배치 표준]
┌─────────────────────────────────────────────────────────────┐
│ Tier 1: 전사 불변 시스템 가드레일 (변경 빈도: 수개월에 1회)    │ ◄── [Breakpoint 1]
│ - 정적 페르소나, 출력 JSON 포맷 제약, 윤리·보안 통제선       │
├─────────────────────────────────────────────────────────────┤
│ Tier 2: 고정 도구 명세 스키마 (Tools) (변경 빈도: 배포 시에만) │ ◄── [Breakpoint 2]
│ - 마이크로서비스 OpenAPI 스키마, 파라미터 유효성 정의          │
├─────────────────────────────────────────────────────────────┤
│ Tier 3: 도메인 정적 지식 베이스 (RAG) (변경 빈도: 세션 내 불변) │ ◄── [Breakpoint 3]
│ - 사내 업무 규정집, 제품 매뉴얼 전문, 기술 명세서 청크        │
├─────────────────────────────────────────────────────────────┤
│ Tier 4: 동적 대화 턴 및 최신 델타 (변경 빈도: 매 요청마다 갱신)│ ◄── [Breakpoint 4 (선택)]
│ - 사용자 질의, 이전 턴 도구 실행 관측 데이터(Observation)     │
└─────────────────────────────────────────────────────────────┘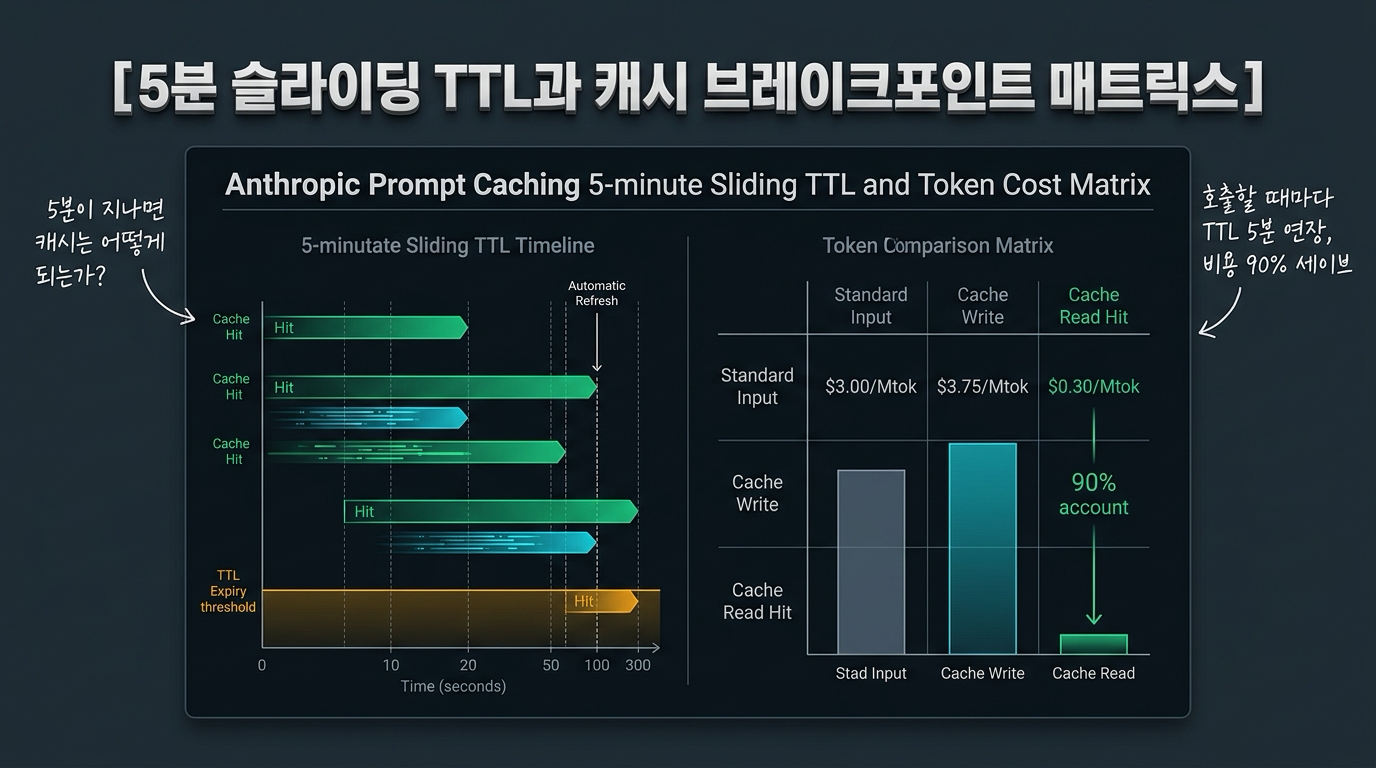
▲ 5분 슬라이딩 TTL은 캐시 적중이 발생할 때마다 만료 시점을 5분 뒤로 자동 연장하며, 캐시 읽기 적중 시 입력 토큰 단가를 $3.00에서 $0.30으로 90% 할인한다.
3.1. 4단계 계층화 원칙
- Tier 1 (불변 시스템 지침): 모든 세션에서 공통으로 공유되는 지침입니다. 모델이 지켜야 할 역할, 제약 사항, 톤앤매너가 포함되며 첫 번째
cache_control을 설정합니다. - Tier 2 (도구 명세 스키마): 에이전트가 호출할 수 있는 도구들의 파라미터 정의입니다. 도구 목록이 고정되어 있다면 이 블록 끝에 두 번째
cache_control을 배치합니다. - Tier 3 (세션 정적 컨텍스트): 사용자가 업로드한 수십 장의 PDF 문서나 검색된 대용량 기술 명세입니다. 세션 동안 변경되지 않으므로 세 번째 브레이크포인트로 고정합니다.
- Tier 4 (동적 대화 턴): 매 턴 새로 추가되는 사용자의 질문과 도구 실행 결과입니다. 여기에는 원칙적으로 브레이크포인트를 두지 않거나, 턴 수가 매우 길어지는 장기 에이전트의 경우 직전 대화 턴 뒤에 네 번째 브레이크포인트를 롤링 방식으로 전진 배치합니다.
4. 프로덕션 파이썬 참조 구현: 캐시 브레이크포인트 및 비용 추적 클라이언트
다음은 Anthropic Python SDK를 활용하여 4단계 프롬프트 계층화 구조를 조립하고, 캐시 적중률과 절감된 비용을 실시간으로 추적하는 프로덕션 레벨의 래퍼 클래스 구현체입니다.
# prompt_cache_agent.py

# (설명을 위한 참조 아키텍처 모델링 코드이며 실제 배포 환경의 인증 및 로깅과 통합 필요)

import os
import time
from typing import List, Dict, Any
from anthropic import Anthropic

class CachedAgentClient:
    """
    Anthropic Prompt Caching 최적화 멀티턴 에이전트 통신 클라이언트.
    Prefix-based 계층화를 강제하고 실제 절감 비용을 토큰 단위로 계측합니다.
    """

    PRICE_STANDARD_INPUT = 3.00 / 1_000_000   # $3.00 per MTok
    PRICE_CACHE_WRITE    = 3.75 / 1_000_000   # $3.75 per MTok (+25%)
    PRICE_CACHE_READ     = 0.30 / 1_000_000   # $0.30 per MTok (-90%)
    PRICE_OUTPUT         = 15.00 / 1_000_000  # $15.00 per MTok

    def __init__(self, api_key: str = None):
        self.client = Anthropic(api_key=api_key or os.environ.get("ANTHROPIC_API_KEY"))
        self.total_saved_cost = 0.0
        self.total_actual_cost = 0.0

    def build_tiered_payload(
        self,
        system_instruction: str,
        static_knowledge_corpus: str,
        messages_history: List[Dict[str, Any]],
        tools: List[Dict[str, Any]]
    ) -> Dict[str, Any]:
        """
        불변 계층에 cache_control을 전략적으로 삽입하여 페이로드를 구성합니다.
        """
        # Tier 1: 불변 시스템 지침 + Tier 3: 세션 정적 코퍼스를 결합한 캐시 블록
        system_blocks = [
            {
                "type": "text",
                "text": system_instruction.strip()
            },
            {
                "type": "text",
                "text": f"\n\n[REFERENCE KNOWLEDGE BASE]\n{static_knowledge_corpus.strip()}",
                "cache_control": {"type": "ephemeral"}  # Breakpoint 1
            }
        ]

        # Tier 2: 고정 도구 스키마의 마지막 원소에 Breakpoint 2 지정
        cached_tools = []
        for idx, tool in enumerate(tools):
            tool_def = dict(tool)
            if idx == len(tools) - 1:
                tool_def["cache_control"] = {"type": "ephemeral"}  # Breakpoint 2
            cached_tools.append(tool_def)

        return {
            "model": "claude-3-5-sonnet-20241022",
            "max_tokens": 4096,
            "system": system_blocks,
            "tools": cached_tools,
            "messages": messages_history
        }

    def execute_turn(self, payload: Dict[str, Any]) -> Any:
        start_time = time.perf_counter()
        response = self.client.messages.create(**payload)
        elapsed = time.perf_counter() - start_time

        # Usage 메트릭에서 캐시 읽기/쓰기 토큰 추출
        usage = response.usage
        input_tokens = getattr(usage, "input_tokens", 0)
        cache_write_tokens = getattr(usage, "cache_creation_input_tokens", 0)
        cache_read_tokens = getattr(usage, "cache_read_input_tokens", 0)
        output_tokens = getattr(usage, "output_tokens", 0)

        # 비용 계산
        actual_cost = (
            (input_tokens * self.PRICE_STANDARD_INPUT) +
            (cache_write_tokens * self.PRICE_CACHE_WRITE) +
            (cache_read_tokens * self.PRICE_CACHE_READ) +
            (output_tokens * self.PRICE_OUTPUT)
        )

        # 캐시가 전혀 없었을 경우의 가상 비용 (전부 기본 입력 토큰으로 청구)
        hypothetical_tokens = input_tokens + cache_write_tokens + cache_read_tokens
        hypothetical_cost = (
            (hypothetical_tokens * self.PRICE_STANDARD_INPUT) +
            (output_tokens * self.PRICE_OUTPUT)
        )
        saved_cost = max(0.0, hypothetical_cost - actual_cost)

        self.total_actual_cost += actual_cost
        self.total_saved_cost += saved_cost

        print(f"⏱️ 지연 시간(Latency): {elapsed:.2f}s | TTFT 최적화")
        print(f"📊 토큰 현황: Write={cache_write_tokens:,} | Read(Hit)={cache_read_tokens:,} | Uncached={input_tokens:,}")
        print(f"💰 이번 턴 비용: ${actual_cost:.5f} (절감액: ${saved_cost:.5f}, 누적 절감: ${self.total_saved_cost:.4f})\n")

return response위 구현에서 알 수 있듯이, cachecreationinputtokens는 첫 턴에서만 집계되고 이후 2턴부터는 cachereadinputtokens로 전량 전환되어 처리 속도와 비용이 극적으로 최적화됩니다.
5. 프로덕션 도입 가이드라인과 4단계 FinOps 점진적 전환 체크리스트
엔터프라이즈 프로덕션 환경에 프롬프트 캐싱을 안정적으로 안착시키기 위해, 아키텍처 팀은 다음 4단계의 점진적 전환 절차를 준수해야 합니다.
[Anthropic Prompt Caching 프로덕션 도입 4단계 로드맵]
+-------------------------------------------------------------------------------+
| Step 1: 프롬프트 정적 토큰 감사 (최소 1,024 토큰 임계치 충족 여부 전수 검사)      |
+-------------------------------------------------------------------------------+
       │
       ▼
+-------------------------------------------------------------------------------+
| Step 2: 전치사 순서 재배치 (동적 파라미터/타임스탬프를 최하단으로 강제 격리)      |
+-------------------------------------------------------------------------------+
       │
       ▼
+-------------------------------------------------------------------------------+
| Step 3: 세션 킵얼라이브(Keep-Alive) 가드레일 (5분 TTL 내 유휴 상태 방어 핑)     |
+-------------------------------------------------------------------------------+
       │
       ▼
+-------------------------------------------------------------------------------+
| Step 4: 실시간 캐시 적중률 모니터링 (Hit Ratio < 75% 시 알람 및 자동 분석)       |
+-------------------------------------------------------------------------------+Step 1: 정적 프롬프트 토큰 감사 및 브레이크포인트 검증
- 모든 에이전트 시스템 프롬프트와 OpenAPI 도구 명세의 토큰 길이를 사전에 계산합니다.
- 총합이 1,024 토큰(Sonnet 기준)에 미달하는 경량 에이전트에는 프롬프트 캐싱을 억지로 활성화하지 않습니다. 최소 분량을 채우지 못한 캐시 선언은 무시되거나 오히려 불필요한 직렬화 오버헤드를 초래할 수 있습니다.
Step 2: 전치사 순서 재배치와 린트 가드레일 구축
- CI/CD 파이프라인에 정적 린트 규칙을 추가하여,
messages또는system블록의 캐시 브레이크포인트 상단에 날짜, 랜덤 UUID, 사용자 입력 문자열이 포함되는 패턴을 커밋 단계에서 빌드 차단합니다. - 우선적으로 정적 공통 가이드라인을 최상단에 고정하고, 사용자별 가변 속성은 캐시 브레이크포인트 하단에 위치시킵니다.
Step 3: 세션 유휴 시간(Idle Time) 킵얼라이브 전략 수립
- 에이전트가 긴 외부 API 호출(웹 스크래핑, 대용량 DB 쿼리 등)을 수행하여 5분이 초과될 위험이 있는 경우, 백그라운드 워커를 통해 4분 30초 시점에 초소형 킵얼라이브 핑(
max_tokens: 1)을 전송하여 수만 토큰의 캐시를 안전하게 연장합니다. - 캐시 쓰기 재할증($3.75)을 지불하는 것보다 최소 출력 토큰(1토큰) 비용으로 5분 TTL을 리셋하는 것이 99% 이상 경제적입니다.
Step 4: FinOps 관측성(Observability) 및 대시보드 연동
- Datadog, CloudWatch 또는 사내 APM에
anthropic.cachereadratio(cachereadtokens / totalinputtokens) 메트릭을 수집합니다. - 프로덕션 환경에서 캐시 적중률이 75% 이하로 하락할 경우 엔지니어링 온콜 알람을 트리거하여, 예상치 못한 프롬프트 포맷 변경이나 캐시 무효화 버그가 발생했는지 신속하게 원인 분석에 착수해야 합니다.
Anthropic Claude Prompt Caching은 단순한 부가 기능이 아닙니다. 자율 에이전트의 연산 단가를 일반 웹 백엔드 수준의 예측 가능한 영역으로 끌어내리는 현대 생성형 AI 아키텍처의 필수 FinOps 기둥입니다. 올바른 계층화 설계를 통해 인프라 비용을 극적으로 낮추고, 압도적인 반응 속도를 확보하십시오.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. Anthropic Claude Prompt Caching Official Documentation
이 글과 함께 읽으면 좋은 인사이트



댓글 0