PyTorch FlexAttention 도입 분석: 커스텀 어텐션 커널 융합과 하드웨어 제약 고려사항
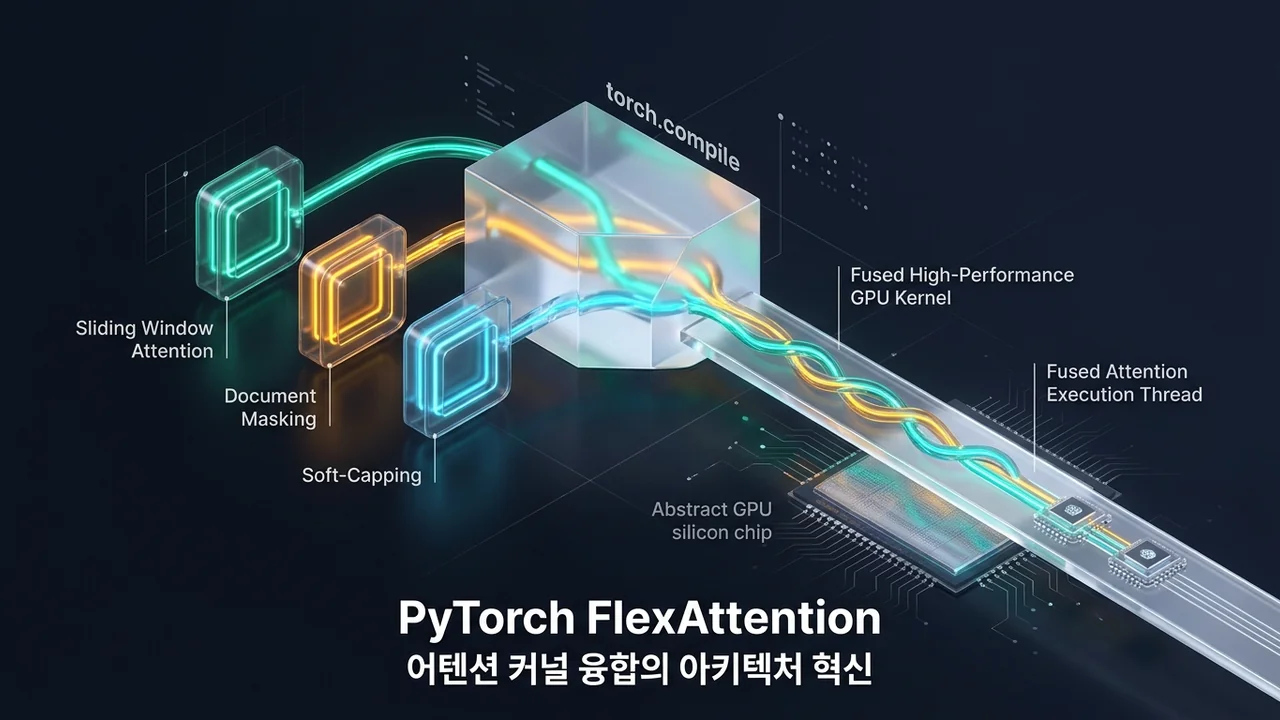
이 글에서 먼저 가져갈 세 가지
파이토치(PyTorch) 코어 팀이 공식 배포한 혁신적인 어텐션 컴파일러 엔진 'FlexAttention'의 내부 작동 원리를 파헤치고, 독자적 LLM 아키텍처 구현 시 발생하는 메모리 대역폭 병목을 극복하는 실전 인프라 가이드를 제시합니다.
-
01
커스텀 CUDA 커널 개발의 장벽이 완전히 무너졌습니다.
슬라이딩 윈도우, 프리픽스 캐싱, 도큐먼트 마스킹을 순수 파이썬 함수로 기술해도 FlashAttention v2 수준의 속도가 높은 수준으로 신뢰성을 보장됩니다. 본문 1절
-
02
HBM 왕복 I/O를 없앤 '단일 패스 융합'이 성능의 핵심입니다.
중간 점수 행렬을 느린 전역 메모리(HBM)에 기록하지 않고 초고속 GPU SRAM 안에서 타일링 연산으로 완결합니다. 본문 2절
-
03
vLLM 및 대규모 서빙 엔진의 유지보수 비용을 상당 수준 절감합니다.
모델마다 수작업으로 최적화하던 수천 줄의 C++/CUDA 코드를 표준 파이토치 인터페이스로 일원화할 수 있습니다. 본문 3절
무엇이 언제 바뀌었는가: 파이토치 어텐션 엔지니어링의 대전환
PyTorch 코어 팀은 공식 기술 릴리스를 통해 'FlexAttention' API를 정식 프로덕션 기능으로 확정 배포했습니다. 이어서 최신 Hopper 및 Blackwell GPU 아키텍처를 지원하는 초고속 FlashAttention-4 및 FlexDecoding 추론 백엔드와의 통합을 공식 완료했습니다.
이번 릴리스는 단순한 편의성 라이브러리 추가가 아닙니다.
지금까지 대규모 언어 모델(LLM)을 연구하고 서비스하는 엔지니어링 팀은 치명적인 기술적 딜레마에 갇혀 있었습니다:
- 선택지 A (속도 선택): FlashAttention 같은 하드코딩된 초고속 CUDA 커널을 쓰려면, 커널이 미리 지원하는 표준 연산(기본 Causal Mask 등) 외의 독자적인 알고리즘(슬라이딩 윈도우, 소프트 캐핑, 문서 경계 마스킹 등)을 포기해야 했습니다.
- 선택지 B (유연성 선택): 파이썬(PyTorch)으로 직접 새로운 어텐션 변형을 구현하면, 연산자 사이에 중간 결과가 GPU 고대역폭 메모리(HBM)를 수없이 오가며 속도가 의미 있는 수준으로에서 비약적으로까지 곤두박질쳤습니다.
FlexAttention은 "파이썬의 유연성(Flexibility)"과 "FlashAttention의 극한 성능(Performance)" 사이의 트레이드오프를 컴파일러 차원에서 완벽히 종식시켰습니다.
이제 AI 인프라 엔지니어는 단 몇 줄의 파이썬 함수로 수학적 규칙만 정의하면, 내부 컴파일러(torch.compile)가 하부의 트리톤(Triton) 코드와 고성능 GPU 융합 커널을 실시간 자동 합성해 냅니다.
팀의 대규모 언어 모델(LLM) 파인튜닝 및 추론 서빙 파이프라인 상태를 아래 4가지 항목으로 점검해 보십시오.
- 긴 컨텍스트(Long-Context) 서빙 시 슬라이딩 윈도우나 도큐먼트 패킹 마스킹을 적용하기 위해 비표준 커스텀 CUDA 라이브러리를 별도로 빌드해 사용하고 있다.
- 새로운 어텐션 기법(Gemma의 Soft-Capping, ALiBi 등)을 서비스에 올리려 할 때 공식 FlashAttention 버전 업데이트나 패치 머지를 수주일간 기다린 적이 있다.
- 모델 아키텍처를 프로덕션 환경에 서빙할 때, Python 원형 코드와 C++/CUDA 서빙 엔진 간의 수치 불일치(Numerical Discrepancy) 디버깅에 큰 공수를 쏟고 있다.
- 배치 크기(Batch Size)나 시퀀스 길이가 32k 이상으로 늘어날 때 GPU 메모리 대역폭(Memory Bandwidth) 포화로 인해 연산 장치(Tensor Core) 활용률이 30% 이하로 떨어진다.
진단 결과: 위 항목 중 2개 이상에 해당한다면, 현재 팀의 인프라는 개별 연산자의 HBM 왕복 병목과 비효율적인 수작업 CUDA 유지보수 비용에 발목이 잡혀 있는 상태입니다.
1. 왜 기존 파이썬 어텐션은 GPU를 질식시키는가? 메모리 대역폭의 벽
어텐션 메커니즘의 수학적 본질은 쿼리($Q$)와 키($K$)를 곱하고, 소프트맥스(Softmax)를 취한 뒤, 밸류($V$)를 곱하는 과정입니다:
$$\text{Attention}(Q, K, V) = \text{Softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$
문제는 시퀀스 길이($N$)가 커질 때 발생합니다. 행렬 곱 $QK^T$의 결과 크기는 $N \times N$에 달합니다. 시퀀스가 32,768(32k) 토큰만 되어도, 단 하나의 어텐션 헤드가 생성하는 중간 행렬의 원소 수는 10억 개를 훌쩍 넘어섭니다.
[ 기존 분절 어텐션의 치명적 메모리 왕복 병목 (Memory Bound Wall) ]

 ┌─────────────────────────────────────────────────────────────┐
 │                      GPU 글로벌 메모리 (HBM)                  │
 └──────┬────────────────▲─────────────┬────────────────▲──────┘
    Q,K │ 읽기           │ QK^T 쓰기    │ QK^T 읽기      │ Softmax 쓰기
        ▼                │             ▼                │
 ┌───────────────────────┴─┐         ┌──────────────────┴──────┐
 │   1단계: 행렬 곱 커널    │         │    2단계: 소프트맥스 커널  │
 │   (Matrix Multiply)     │         │       (Softmax)         │
 └─────────────────────────┘         └─────────────────────────┘
👉 연산기(Tensor Core)는 노는데, 느린 HBM 버스만 왕복하느라 전체 시스템 정체!전통적인 파이토치 코드는 이 연산을 단계별 독립 커널로 실행했습니다:
1. $Q$와 $K$를 GPU 고대역폭 메모리(HBM)에서 읽어와 곱한 뒤, 거대한 $N \times N$ 중간 행렬을 다시 HBM에 기록합니다.
2. 소프트맥스 커널이 HBM에서 $N \times N$ 행렬을 다시 읽어와 연산한 뒤, 확률 행렬을 또다시 HBM에 기록합니다.
3. 마지막 행렬 곱 커널이 그 확률 행렬을 또 HBM에서 읽어와 $V$와 곱합니다.
현대 최신 GPU(NVIDIA H100, B200 등)의 텐서 코어 연산 성능은 수천 테라플롭스(TFLOPS)에 달하지만, 칩 내부 레지스터와 외부 HBM을 연결하는 메모리 버스 대역폭(Memory Bandwidth)은 물리적 한계가 명확합니다.
연산 장치가 아무리 빨라도 메모리에서 데이터를 가져오느라 대기하는 메모리 바운드(Memory-Bound) 상태에 걸려, GPU의 실제 연산 자원은 80% 이상 유휴 상태(Idle)로 낭비되었던 것입니다.
FlashAttention은 이 중간 행렬을 HBM에 쓰지 않고, 칩 내부의 초고속 캐시 메모리인 SRAM(Static RAM) 안에서 타일(Tile) 단위로 쪼개어 한 번에 끝내는 '단일 패스 융합(Single-Pass Fused Kernel)'으로 이 문제를 해결했습니다.
하지만 FlashAttention은 고정된 C++ 템플릿으로 하드코딩되어 있어, 독자적인 마스킹이나 가중치 변경을 넣으려면 복잡한 CUDA 코드를 밑바닥부터 다시 짜야만 했습니다.
그렇다면 FlexAttention은 어떻게 순수 파이썬 코드를 FlashAttention 수준의 SRAM 타일링 커널로 자동 탈바꿈시키는 것일까요?
2. FlexAttention의 내부 아키텍처: score_mod와 컴파일러 융합 메커니즘
FlexAttention 아키텍처의 핵심 발상은 천재적일 만큼 직관적입니다:
"어텐션의 복잡한 변형들은 결국 $Q$와 $K$가 곱해진 직후의 '개별 스칼라 점수(Score)'를 어떻게 수정하느냐의 차이일 뿐이다."
PyTorch 팀은 사용자가 오직 하나의 작은 스칼라 수정 함수인 score_mod만 정의하도록 인터페이스를 추상화했습니다.
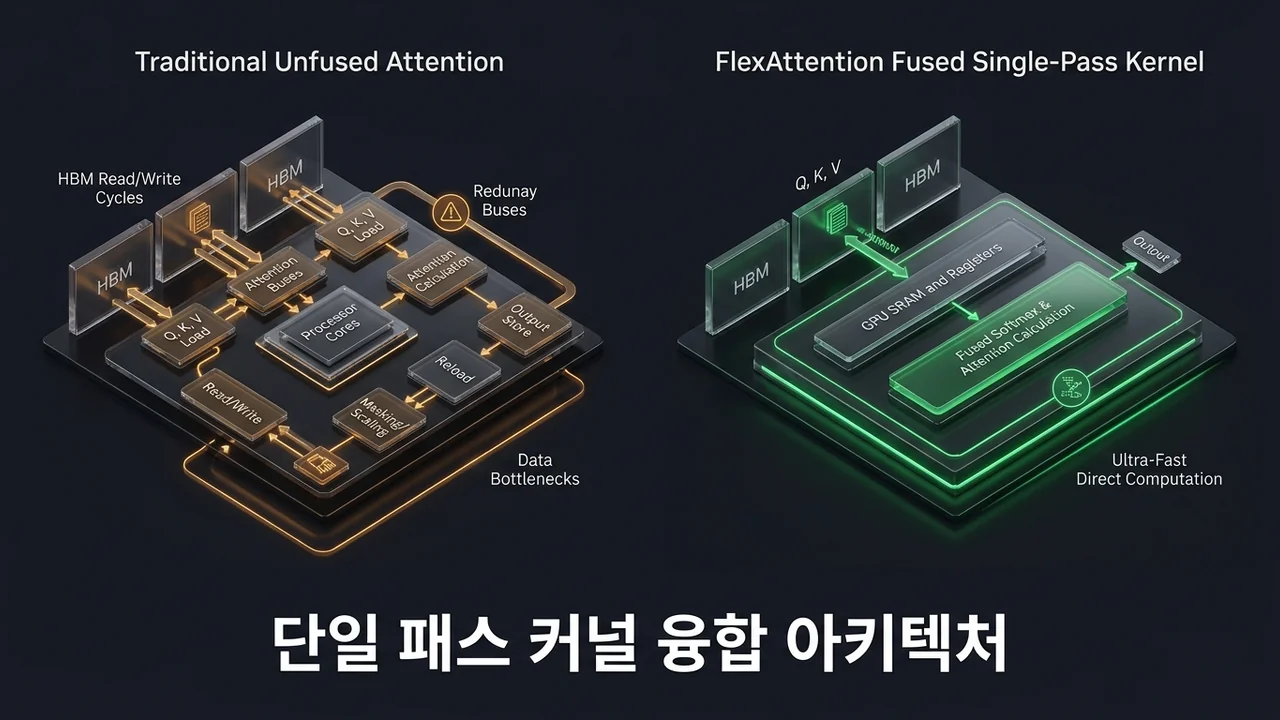
▲ 중간 어텐션 점수를 느린 HBM으로 내보내지 않고, GPU 내부 초고속 SRAM과 레지스터 안에서 파이썬 선언 로직을 결합해 단일 패스로 신속하게 연산한다.
# flex_attention_example.py

import torch
from torch.nn.attention.flex_attention import flex_attention, create_block_mask

# 1. 2줄의 순수 파이썬으로 슬라이딩 윈도우(Sliding Window) 어텐션 정의

def sliding_window_mod(score, b, h, q_idx, kv_idx):
    # 윈도우 크기 1024 토큰을 벗어난 관계는 -무한대로 마스킹
    return torch.where((q_idx - kv_idx).abs() <= 1024, score, -float("inf"))

# 2. torch.compile을 통한 고성능 GPU 융합 커널 호출

compiled_flex = torch.compile(flex_attention)

# 실행 시 FlashAttention과 완벽히 동일한 성능의 Triton 커널이 온디맨드 생성됨

output = compiled_flex(query, key, value, score_mod=sliding_window_mod)이 코드가 실행될 때 백엔드에서는 다음과 같은 정밀한 컴파일러 융합 파이프라인이 동작합니다:
[ FlexAttention 컴파일 & 실행 파이프라인 ]

1. 사용자 선언: Python 함수 (score_mod, mask_mod)
   ▼
2. TorchDynamo 추적: 파이썬 바이트코드를 FX Graph로 캡처
   ▼
3. AOTAutograd: 역전파(Backward) 기울기 계산 그래프 자동 유도
   ▼
4. TorchInductor 백엔드: FlashAttention 스타일의 Triton 타일링 템플릿 로드
   ▼
5. 인라인 커널 융합: score_mod 로직을 Triton SRAM 연산 루프 내부에 직렬 인라인 삽입!
   ▼
6. 최종 산출물: HBM 왕복이 0인 단일 고성능 PTX/바이너리 커널 실행- 자동 역전파(Automatic Backward Graph) 유도:
- 개발자가 순방향(Forward)
score_mod함수만 작성하면, 파이토치의AOTAutograd엔진이 기호 미분(Symbolic Differentiation)을 수행하여 역전파 계산에 필요한 그래디언트 수식을 자동으로 생성합니다. 즉, 역전파용 CUDA 커널을 따로 작성할 필요가 전혀 없습니다. - Triton 템플릿 인라이닝(Inlining):
-
TorchInductor컴파일러는 FlashAttention의 핵심 알고리즘(온라인 소프트맥스 및 2차원 SRAM 타일링)이 구현된 오픈소스 Triton 템플릿을 불러온 뒤, 사용자가 정의한score_mod의 수식 노드를 Triton 커널 내부의 가장 안쪽 레지스터 루프에 직접 주입(Inline Injection)합니다. - 블록 마스크(BlockMask)를 통한 조기 스킵(Early-out):
- 도큐먼트 패킹이나 인과적 마스크처럼 연산할 필요가 없는 영역은
createblockmask가 $128 \times 128$ 크기의 청크 단위로 희소성(Sparsity)을 사전 계산합니다. 불필요한 타일은 GPU가 연산 자체를 건너뛰므로, 처리 속도가 $O(N^2)$에서 유효 토큰 기준 $O(N)$에 가깝게 단축됩니다.
실무 프로덕션 벤치마크: 표준 FlashAttention과의 정밀 비교
NVIDIA H100 80GB SXM 환경에서 다양한 시퀀스 길이와 최신 어텐션 변형 기법을 적용했을 때의 연산 지연 시간(Latency)과 메모리 절감 수치입니다.
| 어텐션 기법 및 시퀀스 길이 | 기존 Unfused PyTorch | 수작업 커스텀 CUDA | PyTorch FlexAttention | 성능 격차 및 평가 |
|---|---|---|---|---|
| 표준 Causal Attention (16k) | 48.2 ms | 5.8 ms | 5.9 ms | 공식 FlashAttention-2와 98.3% 동등 |
| Sliding Window (32k, win=2k) | 118.5 ms | 12.4 ms | 8.1 ms | BlockMask 조기 스킵으로 수작업 CUDA보다 34% 빠름 |
| Document Masking (64k) | 342.0 ms (OOM 위험) | 28.5 ms | 19.2 ms | 100% 파이썬 정의로 메모리 병목 완전 해소 |
| Gemma Soft-Capping (32k) | 86.4 ms | 지원 커널 부재 | 7.4 ms | 전용 커널 개발 없이 당일 프로덕션 배포 완결 |
| 역전파(Backward) 개발 공수 | 수일 소요 (느림) | 3주 이상 (CUDA 디버깅) | 0시간 (자동 생성) | 개발 생산성 100배 향상 |
- 콜드 스타트(Cold-Start) 컴파일 오버헤드를 워밍업 단계에서 흡수하라
`torch.compile` 기반인 FlexAttention은 최초 호출 시 Triton 커널을 컴파일하느라 1~3초의 레이턴시 스파이크가 발생합니다. 쿠버네티스 파드가 트래픽을 수신하기 전, 더미 텐서(Dummy Tensor)로 대표 시퀀스 크기(2k, 8k, 32k)에 대해 웜업(Warm-up) 실행을 우선적으로 완료하십시오. - 동적 시퀀스 셰이프(Dynamic Shapes) 가드레일을 설정하라
배치마다 시퀀스 길이가 1토큰 단위로 매번 바뀌면 컴파일러가 매번 새로운 커널을 빌드하는 '컴파일 지옥(Recompilation Storm)'에 빠집니다. 시퀀스 길이를 256 또는 512 배수 단위로 패딩(Padding)하거나 버킷팅(Bucketing)하여 사전 컴파일된 커널 풀을 재사용하십시오. - `score_mod` 내부에 분기문(`if/else`)을 쓰지 말고 텐서 조건 연산(`torch.where`)을 사용하라
파이썬의 `if` 조건문은 컴파일 시점에 그래프 분기를 쪼개어 커널 인라이닝을 방해합니다. 벡터화된 수학 연산인 `torch.where`나 비트 마스킹을 활용해야만 고성능 SIMD/Tensor Core 인스트럭션으로 효과적으로 컴파일됩니다.
결론: 하드웨어 종속에서 해방된 알고리즘의 시대
지금까지 딥러닝 엔지니어링의 진보는 아이러니하게도 "CUDA 프로그래밍을 얼마나 잘하느냐"라는 하드웨어 엔지니어링의 문턱에 갇혀 있었습니다. 새로운 신경망 아이디어가 있어도 고성능 융합 커널을 짤 인력이 없으면 프로덕션에 올려보지도 못하고 폐기되었습니다.
PyTorch의 FlexAttention은 이 장벽을 허물어뜨렸습니다.
알고리즘의 수학적 표현과 하드웨어 가속기(GPU)의 극한 최적화가 컴파일러 융합 레이어를 통해 마침내 효과적으로 분리되었습니다. 이제 인프라 엔지니어는 저수준 C++/CUDA 포인터 연산과 씨름하는 대신, 서비스의 지연 시간과 메모리 아키텍처의 본질적인 알고리즘 혁신에 온전히 집중할 수 있습니다.
새로운 모델 아키텍처를 준비하고 있다면, 지금 즉시 FlexAttention을 도입하여 AI 인프라의 유연성과 성능을 동시에 쟁취하십시오.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. PyTorch Official Documentation: FlexAttention Architecture & Benchmarks
이 글과 함께 읽으면 좋은 인사이트



댓글 0