대시보드 과밀과 통제의 착각: 실행 가능한 SLO 중심의 관측 신호 설계 원칙
이 글에서 먼저 가져갈 세 가지
개발팀과 SRE 조직이 대시보드 중독에서 벗어나지 못하는 심리학적 기전을 파헤치고, 시각적 허영을 걷어내어 실제 장애 대응 속도를 극대화하는 신호 정제 아키텍처를 제시합니다.
-
01
대시보드를 쳐다보는 행위는 심리적 방어 기제에 가깝습니다.
수많은 차트를 모니터에 띄워놓는 것은 불안을 잠재우기 위한 의식(Ritual)일 뿐 실제 시스템 안정성을 증명하지 못합니다. 본문 1절
-
02
작업 기억 한계를 초과한 지표는 신호 탐지 이론상 소음이 됩니다.
인간의 뇌가 동시에 처리할 수 있는 정보 청크를 넘어서는 순간 경보 피로와 신호 누락이 필연적으로 발생합니다. 본문 2절
-
03
행동 가능한 3대 골든 시그널과 에러 버짓 파이프라인으로 전환해야 합니다.
수동 대시보드 감시를 전면 폐지하고, 임계치 위반 시 조치 절차(Runbook)가 강제되는 SLO 기반 능동 경보를 구축합니다. 본문 3절
1. 관측 가능성의 착각: 우리는 왜 복잡한 대시보드에 집착하는가
대규모 분산 시스템을 운영하는 현대 엔지니어링 팀의 사무실이나 원격 근무 화면을 살펴보면, 흔히 마주치는 상징적인 풍경이 있습니다. 여러 대의 모니터에 빈틈없이 펼쳐진 수십 개의 그라파나(Grafana) 대시보드, 1초 단위로 요동치는 CPU 사용률 그래프, 그리고 쉴 새 없이 스크롤되는 로그 스트림입니다. 팀원들은 이러한 관측 환경을 구축해 두고 주기적으로 화면을 응시하며 "우리 시스템은 철저히 모니터링되고 있으며 통제 하에 있다"는 강한 확신을 갖습니다.
그러나 냉정하게 현실을 되돌아보면 역설적인 진실이 드러납니다. 실제 치명적인 서비스 장애가 발생했을 때, 그 징후를 가장 먼저 발견하고 문제를 해결하는 단초는 그 화려한 대시보드가 아닙니다. 대부분의 경우 고객센터의 불만 접수나 결제 실패율 급증 알림, 혹은 슬랙 채널로 쏟아지는 동료들의 멘션을 통해 장애를 비로소 인지하게 됩니다. 장애가 터진 직후 엔지니어들이 허겁지겁 대시보드를 열어보아도, 이미 수십 개의 그래프가 일제히 붉은색으로 치솟아 있어 도대체 어떤 컴포넌트가 최초의 근본 원인(Root Cause)인지 분별하지 못한 채 우왕좌왕합니다.
왜 우리는 시스템 안정성에 실질적인 기여를 하지 못하는 대시보드 구축과 감시에 그토록 많은 시간과 인지 자원을 쏟아붓는 것일까요?
이 현상의 심리학적 뿌리는 하버드 대학교 심리학자 엘렌 랭거(Ellen Langer, 1975)가 규명한 통제의 착각(Illusion of Control) 이론에서 정확히 설명됩니다. 랭거의 기념비적 연구에 따르면, 인간은 본질적으로 우연이나 통제할 수 없는 외부 요인에 의해 좌우되는 복잡한 상황에서도, 자신이 능동적인 선택을 하거나 적극적인 행위를 취하고 있다는 느낌을 받으면 결과에 대한 통제력을 실제보다 과도하게 높게 평가하는 인지적 왜곡을 겪습니다.
복잡계 분산 시스템은 네트워크 단절, 클라우드 인프라의 노이즈 네이버(Noisy Neighbor), 비결정론적 동시성 버그 등 본질적으로 불확실성과 무작위성이 지배하는 영역입니다. 엔지니어는 이러한 거대한 불확실성 앞에서 깊은 무력감과 불안감을 느낍니다. 이때 프로메테우스 쿼리를 정교하게 다듬어 새로운 패널을 추가하고, 화려한 색상의 게이지 차트를 배치하는 행위는 불안을 달래기 위한 강력한 심리적 방어 기제(Psychological Defense Mechanism)로 작동합니다. 즉, 시스템 내부의 복잡성을 길들이지 못하면서도 "나는 모니터링 시스템을 직접 구축하고 관리하고 있다"는 능동적 행위 자체에 몰입함으로써, 통제 불가능한 대상을 완벽히 장악했다는 가짜 안도감을 얻는 것입니다.
2. 신호 탐지 이론과 작업 기억의 병목: 왜 차트가 많을수록 장애를 놓치는가
대시보드 과밀(Dashboard Bloat)이 위험한 이유는 단순히 개발자의 시간을 낭비하는 것에 그치지 않습니다. 인간의 뇌 신경계가 정보를 처리하는 생물학적 한계를 직접적으로 침해하여, 실제 위험 신호에 대한 탐지 감도를 영구적으로 저하시키기 때문입니다.
인지심리학에서 인간의 작업 기억(Working Memory) 용량은 극도로 제한된 자원입니다. 인지과학 분야에서 인간의 작업 기억(Working Memory) 용량은 동시에 4개 내외의 청크(Chunk)만을 안정적으로 처리할 수 있다는 넬슨 코완(Nelson Cowan, 2001)의 연구는 시각적 정보 처리에도 동일하게 적용됩니다. 단일 화면에 20개, 30개의 그래프 위젯이 빽빽하게 채워져 있을 때, 온콜 엔지니어의 뇌는 각각의 지표를 독립적으로 해석하지 못하고 하나의 거대한 시각적 소음(Visual Noise)으로 뭉뚱그려 인식하게 됩니다.
이를 인지공학의 신호 탐지 이론(Signal Detection Theory, SDT) 관점에서 모델링하면 다음과 같은 파국적 경로가 형성됩니다:
[ 방대한 텔레메트리 데이터 ]
(CPU, 메모리, 스레드 풀, GC, 네트워크 I/O, 디스크 초당 입출력 수)
                 |
                 v
[ 과밀한 원시 대시보드 노출 ] ---> 시각적 주의력 분산 및 기준점 왜곡
                 |
                 +-----------------------------------+
                 |                                   |
                 v                                   v
        [ 높은 거짓 경보율 ]              [ 신호 탐지 임계점 상향 ]
      (False Alarm: 잦은 늑대 알림)       (엔지니어의 무의식적 피로 반응)
                 |                                   |
                 +-----------------+-----------------+
                                   |
                                   v
                      [ 치명적 미탐(Miss) 발생 ]
실제 침해 및 잠재 장애 신호 은폐대시보드에 원시 메트릭(Raw Metrics)이 많아질수록 일시적인 트래픽 스파이크나 일상적인 백그라운드 배치 작업으로 인한 지표 튐 현상이 빈번하게 시각적 자극을 유발합니다. 이로 인해 인지 시스템은 '거짓 경보(False Alarm)'를 끊임없이 수신하게 됩니다. 잦은 거짓 경보에 노출된 인간의 뇌는 에너지 고갈을 막기 위해 스스로 신호 판별 임계치(Criterion)를 높여버립니다. 그 결과, "저 그래프는 원래 가끔 튀는 거니까 괜찮아", "평소에도 퇴근 시간대엔 저 수치였어"라며 실제 장애로 이어지는 결정적 미세 신호를 소음으로 간주하고 무시해 버리는 주의 누합(Attentional Invalidation) 상태에 빠집니다.
결국 모니터링 화면을 빼곡하게 채우는 행위는 통제력을 강화하기는커녕, 위험에 대한 팀의 반응 속도를 체계적으로 둔화시키는 자가당착을 낳습니다.
3. 행동 가능한 신호(Actionable Signals) 아키텍처와 오류 예산 설계
그렇다면 엔지니어링 조직은 대시보드 과밀과 통제의 착각에서 어떻게 탈출해야 할까요? 해법은 "모니터링(Monitoring)"에서 "행동 가능한 관측성(Actionable Observability)"으로의 철학적 전환에 있습니다.
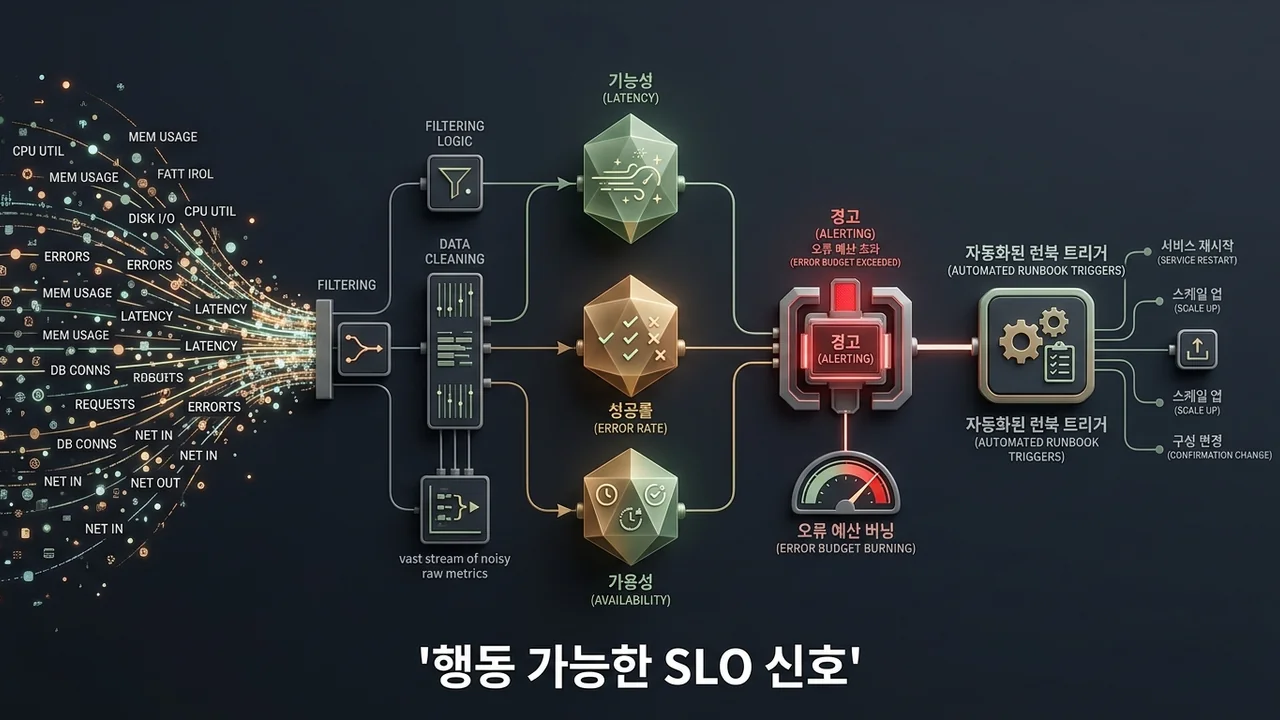
▲ 시스템 내부의 수만 가지 원시 메트릭을 수동 감시하는 대신, 사용자 경험에 직결된 지연시간·오류율·가용성 신호로 압축하고 에러 버짓 소진율과 런북 실행을 직접 결합하는 엔지니어링 메커니즘을 나타낸다.
수동 감시의 폐지와 무대시보드 원칙
가장 먼저 단행해야 할 조치는 "사람이 모니터를 바라보며 이상을 감시하는 행위"를 프로세스에서 공식적으로 제거하는 것입니다. 사람은 기계적인 시계열 데이터의 변화를 지속적으로 탐지하는 작업에 가장 부적합한 인지 구조를 가지고 있습니다. 대시보드는 상시 감시용(Watching)이 아니라, 시스템이 먼저 알람을 보냈을 때 원인을 심층 추적(Debugging)하기 위한 디버깅 도구로 재정의되어야 합니다.
골든 시그널 기반 SLO 신호 정제
내부 구현 지표(CPU 사용률, 힙 메모리 점유율, 디스크 I/O)는 경보의 주체가 될 수 없습니다. CPU가 95%에 달하더라도 사용자의 API 응답 시간이 50ms 이내이고 오류가 발생하지 않는다면, 그것은 장애가 아니라 하드웨어 자원을 극도로 효율적으로 활용하고 있는 정상 상태입니다. 반대로 CPU가 10%에 불과하더라도 외부 서드파티 결제 API가 락(Lock)에 걸려 모든 사용자의 요청이 타임아웃되고 있다면 그것이 최악의 장애입니다.
따라서 모든 관측 신호는 시스템 내부 구현이 아닌 사용자가 체감하는 경험(User Experience)에 닻을 내려야 합니다. Google SRE가 제안한 핵심 지표 중 다음 세 가지 골든 시그널만을 최상위 신호로 격상합니다:
- 가용성(Availability / Error Rate): 전체 성공 요청 대비 유의미한 HTTP 5xx 또는 비즈니스 실패 비율
- 지연 시간(Latency): p99 및 p95 요청의 처리 시간이 사전 정의된 사용자 인내 한계를 초과하는지 여부
- 처리량(Throughput / Saturation): 시스템이 단위 시간당 처리 가능한 최대 요청 도달 여부
아래 프로메테우스 및 오픈텔레메트리 기반 알림 규칙 예시는 원시 CPU 메트릭을 배제하고, 오류 예산 소진율(Error Budget Burn Rate)에 기반하여 진정한 행동이 요구될 때만 트리거되는 멀티 윈도우 알림 설계입니다.
# 행동 가능한 SLO 신호 기반 Prometheus 알림 규칙 설계 (프로덕션 레퍼런스)

# 본 규칙은 단순 임계치가 아닌 오류 예산 소진 속도(Burn Rate)를 기반으로 작동합니다.

groups:
  - name: production-actionable-slo-alerts
    rules:
      # 1시간 동안 30일 오류 예산의 2%가 소진되는 급격한 장애 (Burn Rate 14.4)
      - alert: CriticalErrorBudgetBurnFast
        expr: |
          (
            sum(rate(http_requests_total{status=~"5.."}[1h]))
            /
            sum(rate(http_requests_total[1h]))
          ) > (1 - 0.999) * 14.4
          and
          (
            sum(rate(http_requests_total{status=~"5.."}[5m]))
            /
            sum(rate(http_requests_total[5m]))
          ) > (1 - 0.999) * 14.4
        for: 2m
        labels:
          severity: critical
          tier: user-facing-service
        annotations:
          summary: "결제 API 서비스의 30일 오류 예산이 급격히 소진되고 있습니다 (Burn Rate 14.4x)"
          description: "최근 1시간 내 에러율이 허용 임계치를 14배 초과했습니다. 단계적인 온콜 대응이 필요합니다."
          runbook_url: "https://wiki.internal.net/runbooks/checkout-service-latency-5xx"
          action_required: "쿠버네티스 파드 재시작 또는 카나리 트래픽 즉시 차단(롤백)"

      # 6시간 동안 오류 예산의 5%가 완만하게 소진되는 만성 장애 (Burn Rate 6)
      - alert: HighErrorBudgetBurnSlow
        expr: |
          (
            sum(rate(http_requests_total{status=~"5.."}[6h]))
            /
            sum(rate(http_requests_total[6h]))
          ) > (1 - 0.999) * 6
          and
          (
            sum(rate(http_requests_total{status=~"5.."}[30m]))
            /
            sum(rate(http_requests_total[30m]))
          ) > (1 - 0.999) * 6
        for: 15m
        labels:
          severity: warning
          tier: user-facing-service
        annotations:
          summary: "결제 API 서비스의 오류 예산이 점진적으로 누수되고 있습니다 (Burn Rate 6x)"
          description: "최근 6시간 동안 완만한 품질 저하가 지속 중입니다. 근무 시간 내 우선 분석이 권장됩니다."
          runbook_url: "https://wiki.internal.net/runbooks/slow-burn-investigation"
action_required: "의존성 외부 서드파티 레이턴시 지표 및 최근 배포 diff 확인"4. 팀의 인지 안전을 위한 관측성 정리 프로토콜과 실무 가이드
엔지니어링 팀이 대시보드 중독을 끊어내고 심리적 평정과 진정한 복원력을 회복하기 위해서는, 코드 리팩터링과 마찬가지로 모니터링 자산에 대한 주기적인 감가상각과 정리 의식을 도입해야 합니다.
다음 질문에 솔직하게 답해 보십시오: 지난 한 달간 발생한 주요 장애 중 대시보드를 눈으로 보고 먼저 알아챈 비율이 20%를 넘습니까? 온콜 알람이 울렸을 때 런북을 보지 않고도 첫 번째로 취해야 할 조치가 명확합니까? 지난 3개월 동안 단 한 번도 보지 않은 대시보드 패널이 전체의 절반 이상을 차지하지 않습니까?
본 리포트에서 제안하는 실무 운영 기준으로서, 엔지니어링 온콜 교대 시 대시보드를 열어두고 수동 감시하는 행위를 원칙적으로 금지하고, 런북 링크가 부착되지 않은 슬랙 채널 알림은 생성 자체를 불허하는 무대시보드 운영 프로토콜(Zero-Dashboard Operations)을 제안합니다.
구체적인 실천 단계는 다음과 같습니다:
- 대시보드 일몰(Sunset) 분기제 도입
- 매 분기 말 스프린트에 '관측성 디톡스(Observability Detox)' 데이를 지정합니다. 최근 90일 동안 조회 횟수가 5회 미만인 대시보드는 예외 없이 보관소(Archive)로 이관하거나 삭제합니다. 차트가 사라지는 것에 불안을 느끼는 팀원에게는 "필요하면 쿼리 히스토리에서 언제든 복원할 수 있다"는 확신을 주어야 합니다.
- 알람과 실행 조치(Action)의 1:1 강제 결합
- "알람이 발생했을 때 엔지니어가 지금 당장 취할 수 있는 구체적 행동이 무엇인가?"라는 질문에 명확한 답변이 없다면, 그 알람은 즉시 삭제되어야 마땅합니다. "확인용 알람"이나 "참고용 슬랙 봇"은 인지적 대역폭을 갉아먹는 독성 자산입니다. 모든 페이저(Pager) 경보에는 3단계 이내로 복구를 시도할 수 있는 런북(Runbook) URL이 의무적으로 포함되어야 합니다.
- 장애 회고 시 '대시보드 추가'를 재발 방지책으로 삼지 않기
- 많은 팀이 포스트모템(Post-mortem) 회고에서 "다음엔 이 장애를 놓치지 않기 위해 관련 지표 대시보드를 추가하겠다"는 항목을 액션 아이템으로 채택합니다. 이는 통제의 착각을 제도적으로 재생산하는 최악의 패턴입니다. 대시보드를 추가할 것이 아니라, "왜 기존의 SLO 경보가 에러 버짓 소진을 탐지하지 못했는가?"를 분석하고, 상위 알림의 수학적 임계치와 평가 윈도우를 조정하는 것이 올바른 엔지니어링 해결책입니다.
진정한 시스템 안정성은 화려한 그래프의 개수가 아니라, 엔지니어가 시스템의 침묵을 신뢰할 수 있는가에 달려 있습니다. 불필요한 차트를 과감히 끄고, 핵심 비즈니스 신호만을 벼려낼 때 비로소 엔지니어링 팀은 통제의 착각에서 벗어나 진정한 통제력을 확보할 수 있을 것입니다.
참고 자료
원문 참고 자료
이 글의 사실 확인과 추가 읽기를 위한 원문입니다. Illusion of Control (Langer) & Google SRE Workbook SLO Dashboard Design
이 글과 함께 읽으면 좋은 인사이트



댓글 0